
لماذا يفشل الروبوت في السكب؟ حل ذكاء اصطناعي من مرحلتين للتقاطع المخصص للمهمة
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
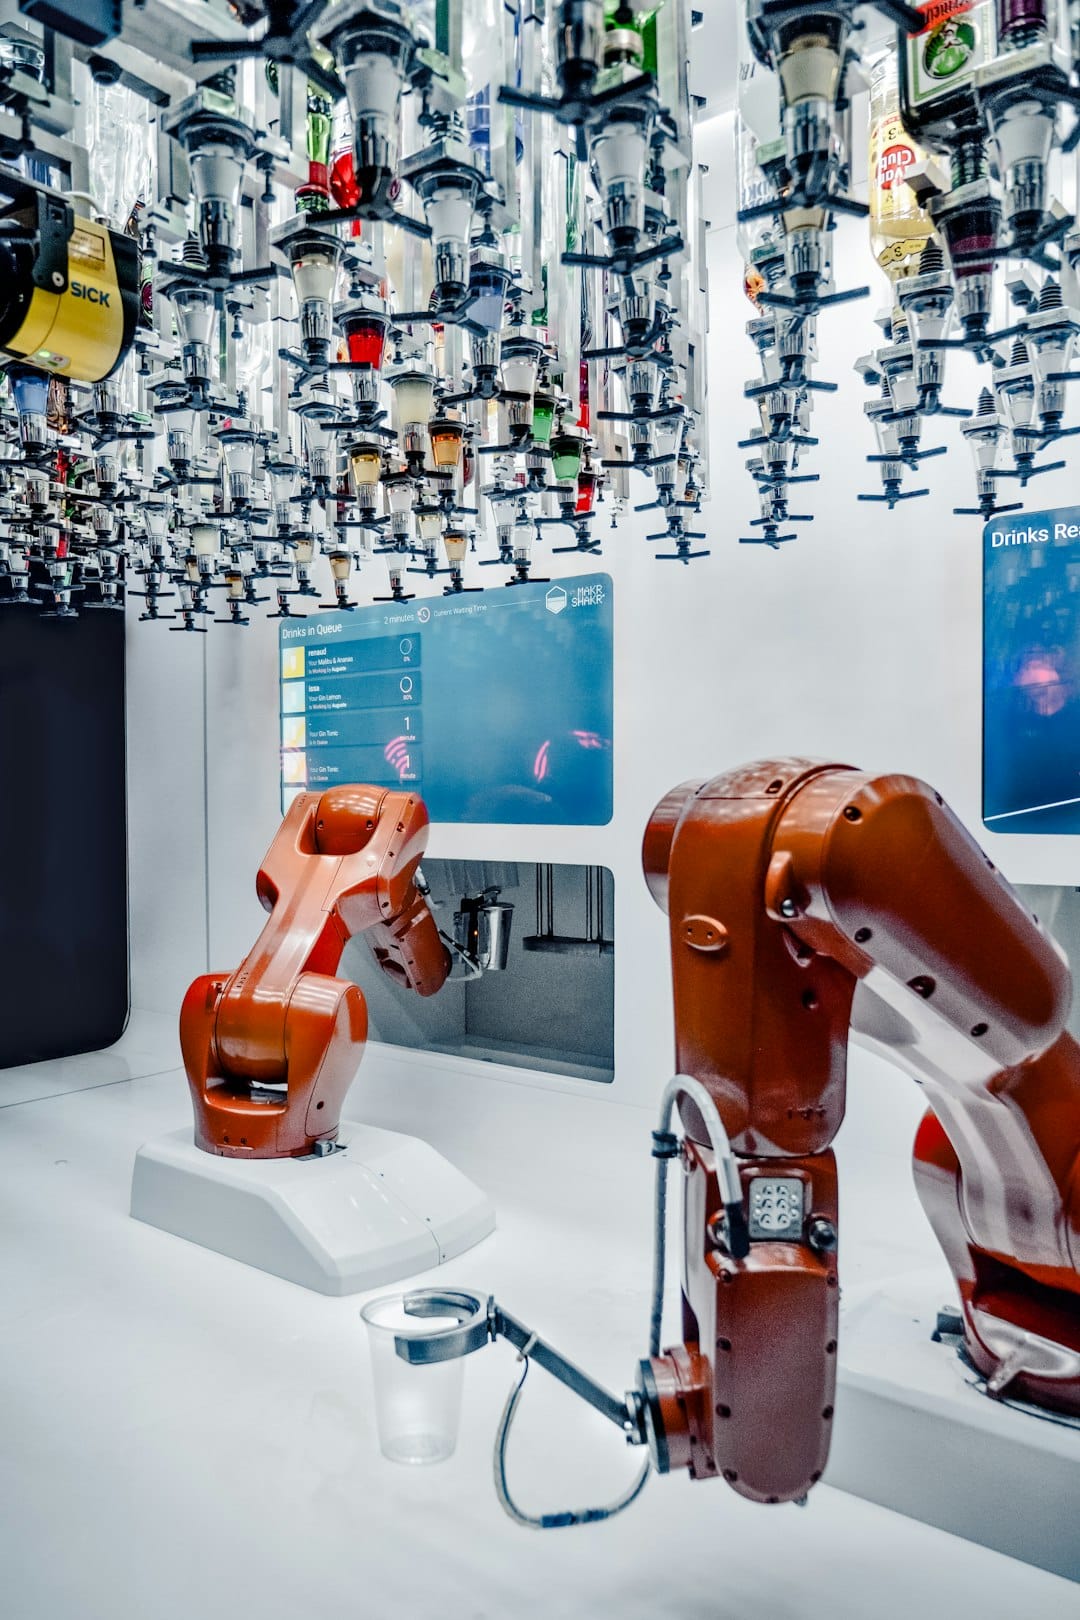
لطالما واجهت المناورات الروبوتية فجوة محددة. تستطيع الأنظمة التقليدية تحديد طرق متعددة لأمساك جسم ما بناءً على هندسته فقط. لكنها تفشل غالباً في اختيار الوضعية التي تتيح إجراءات لاحقة ناجحة. تخيل روبوتا يمسك إبريق الشاي بشكل مثالي لكنه يعجز عن السكب لأنه أغفل الاتجاه الوظيفي للمقبض. يوفر إطار عمل جديد من مرحلتين حلاً لهذه المشكلة عبر فصل توليد الإمساك عن الاستدلال الدلالي. يحسن هذا النهج دقة الاختيار المشروط بالمهمة بشكل ملحوظ.
يعمل النظام في مرحلتين متميزتين لحل هذه الإشكالية. في المرحلة الأولى، يحدد نموذج لغة ورؤية المناطق ذات الصلة بالمهمة ضمن ملاحظة RGB-D. توجه هذه العملية التقطيع وتوليد مرشحات إمساك واقعية سداسية الأبعاد عبر GraspNet. النتيجة هي مجموعة مقترحات تتمتع بصحة هندسية وترتبط بمناطق وظيفية محددة. تستخدم المرحلة الثانية بعد ذلك ناقداً منظماً قائماً على نماذج اللغة والرؤية لترتيب هذه المرشحات المتجذرة. تقييمها يعتمد على التوافق مع المهمة المستهدفة بدلاً من الاعتماد الكلي على الدرجات الهندسية. يمنع هذا النهج المحدود النموذج من توليد أوضاع غير مقيدة. يختار بدلاً من ذلك من مجموعة موثقة من معرفات المرشحين.
أظهرت التقييمات المكثفة عبر ستين تجربة فعلية للنظام الكامل معدل نجاح مهماتي بنسبة 63.3%. شملت الاختبارات مهاماً مثل النقل العشوائي وضرب المطرقة والسكب. كشفت تجارب إعادة التشغيل الخاضعة للرقابة عن تفاوتات كبيرة في الأداء اعتماداً على اختيار نموذج اللغة والرؤية. برز Gemini 3 Flash Preview كأفضل أداء في مرحلة تحديد المواقع الأولى. حقق دقة تبلغ 95.0% مع أقل زمن استجابة. أما في مرحلة الترتيب الثانية، أظهر GPT-5.6 Sol موثوقية فائقة. حصل على معدل صحة مهمة من المرتبة الأولى بنسبة 92.9% وأظهر أقوى اتساق في الاستدلالات المتكررة.
تبرز هذه الدراسة أن إكمال المهام الفعلية وسلوكيات النماذج المحددة تعكس جوانب مختلفة من متانة النظام. أظهر تحليل الحساسية أن التغييرات في أدلة المرشحين الأوائل يمكن أن تغير اختيارات الإمساك النهائية. يؤكد هذا الحاجة إلى تقييم المرحلتين معاً. يوفر هذا الإطار أساساً أوضح لتقييم الأنظمة الروبوتية القائمة على نماذج اللغة والرؤية من خلال عزل الدلالة عن تدقيق المرشحين. يتجاوز مقاييس النجاح البسيطة لفهم أين ولماذا تنجح القرارات أو تفشل. تقدم هذه المنهجية مساراً قابلاً للتوسع لدمج الاستدلال عالي المستوى في التحكم الروبوتي منخفض المستوى. تضمن أن الروبوتات لا تمسك الأجسام فحسب بل تفعل ذلك بطريقة تلبي التعليمات البشرية المعقدة.
Related in Gadgets

Gadgets
لماذا يرفض متصفحك؟ المنطق الخفي وراء رسائل الوصول المرفوض
يتحرك العالم الرقمي بسرعة هائلة. ومع ذلك تظل تجربة واحدة محبطة للجميع في كل مكان. تلك اللحظة المفاجئة التي يتوقف فيها تحميل موقع الويب. تظهر أمامك رسالة صارخة تقول 'تم رفض الوصول' أو رمز HTTP 403 Forbidden. هذا ليس مجرد خطأ عشوائي. إنه إشارة حرجة داخل البنية التحتية الحديثة للويب
Read More...
Gadgets
لماذا يرفض المتصفح الدخول؟ المنطق الخفي وراء رسائل خطأ 'تم رفض الوصول'
هل سبق لك أن وقفت أمام شاشة فارغة ترفض السماح لك بالدخول؟ رسالة 'تم رفض الوصول' المزعجة ليست مجرد عائق رقمي. إنها في الواقع علامة على أن أنظمة أمن الإنترنت تعمل كما هو متوقع تماماً. عندما تظهر لك رمز HTTP 403 Forbidden، فهذا يعني أن الخادم سمع طلبك لكنه قرر عدم منح الإذن. هذه ليس
Read More...
Gadgets
COMBI-CBRN: كيف تعيد المستشعرات المعيارية تعريف سلامة رجال الإطفاء في طوارئ المواد الكيميائية والبيولوجية والإشعاعية والنووية
يهدف الهيكل المقترح إلى تقليل وقت التعامل مع الأدوات وتحسين الوعي الوضعي. يوفر سجلاً معلوماتياً مشتركاً يتتبع أعلام الصلاحية وحل النزاعات ومستويات الأدلة. يتطلب التطوير المستقبلي بناء نموذج أولي مادي، واختبارات بيئية صارمة تحت ظروف موقع الحريق، وتجارب مستخدمين. ستؤدي هذه الخطوات
Read More...
Gadgets
كيف يعزز المحاذاة الواعية بالبنية دقة الذكاء الاصطناعي في التعلم ذو العلامات الجزئية
يواجه عالم الذكاء الاصطناعي عقبة دائمة. البيانات ذات التصنيف الدقيق نادرة ومكلفة للغاية. لجأ الباحثون إلى التعلم ذو العلامات الجزئية كحل لهذه المشكلة. تتيح هذه الطريقة للنماذج التعلم من إشراف غامض. يأتي كل مثال مع مجموعة من العلامات المرشحة. توجد علامة واحدة صحيحة فقط. تكمن التحد
Read More...
Gadgets
الذكاء الاصطناعي يكشف عيوب أبراج نقل الكهرباء ودقة أعلى بنسبة 59 في المئة لسلامة الشبكة
تعتمد الشبكات الكهربائية الحديثة على موثوقية البنية التحتية لنقل الطاقة. لا تزال عمليات التفتيش اليدوي للهياكل الفولاذية الشاهقة مكلفة وتحتاج إلى جهد كبير وعرضة لأخطاء الإنسان. يقدم تقدم حديث في تقنيات الرؤية الحاسوبية حلاً تحويلياً لتحديد نقاط الضعف الهيكلي في أبراج نقل الجهد ال
Read More...
Gadgets
لماذا تم حظر وصولك؟ الآليات الخفية لتحكم الوصول إلى الويب
هل سبق أن وقفت أمام شاشة وتوقفت عند ظهور ثلاثة كلمات مخيفة: "تم رفض الوصول"؟ هذه ليست مجرد عطل تقني بسيط. إنها نتيجة بروتوكولات أمنية متطورة تعمل بجد لحماية موارد الخوادم والبيانات الحساسة. يُعد هذا الظاهرة جزءاً أساسياً من كيفية إدارة المواقع الحديثة لحركة المرور وفرض حقوق النشر
Read More...
Gadgets
حدود مضخمات الفئة د: لماذا يحدد تردد التبديل جودة الصوت
لطالما حظيت مضخمات الفئة د بتقدير كبير بسبب كفاءتها الطاقية المذهلة. لكن تحقيق جودة صوت نقي يتطلب تجاوز شبكة معقدة من القيود التقنية. تقدم دراسة حديثة منشورة في مجلة Electronics التابعة لـ MDPI إطاراً جديداً لاختيار تردد التبديل الأمثل لمراحل الجسر الكامل في مضخمات الفئة د. تشير
Read More...
Gadgets
لماذا تفشل أجهزة استشعار الصوبات الزراعية: فخ توقيت MQTT وكيفية علاجه
تعد الصوبات الذكية واعدةً بتحقيق الزراعة الدقيقة عبر تدفقات بيانات مستمرة. لكن العديد من المزارعين يواجهون واقعاً محبطاً حيث تتعثر شبكات الاستشعار اللاسلكية تحت وطأة تعقيدها الذاتي. تسلط دراسة حديثة نُشرت في مجلة Electronics التابعة لـ MDPI الضوء على هذه المشكلة. تقدم الدراسة إطا
Read More...
Gadgets
Fed-PriLoRA: كيف يحقق التعلم الآلي الموحد الخاص تقليلًا بنسبة 99.95 في المئة في التواصل لنماذج اللغات الكبيرة
أدى دمج نماذج اللغات الكبيرة في قطاعات حساسة مثل الرعاية الصحية والمالية إلى طلب ملح على آليات قوية لحماية البيانات. يتيح التعلم الموحد التدريب عبر أجهزة موزعة دون مشاركة البيانات الخام. لكن ضبط هذه النماذج الضخمة يظل مكلفًا حسابيًا ويستهلك قدرًا كبيرًا من عرض النطاق الترددي. ظهر
Read More...
Gadgets
باحثون سعوديون يحلون مشكلة تقلبات الشبكة المتجددة باستخدام الذكاء الاصطناعي الموجه بالفيزياء
جدة، المملكة العربية السعودية - المصدر: تتغير المشهد العالمي للطاقة بسرعة نحو مصادر الرياح والطاقة الشمسية الكهروضوئية. هذا التحول يجلب تحديا جديدا. التقلب الطبيعي في توليد الطاقة المتجددة يمكن أن يهدد استقرار الشبكة. طرق التنبؤ التقليدية غالبا ما تجد صعوبة في حساب القيود الفيزيا
Read More...