
Cloud-Native-Datenverkehr bricht ständig ab? Fünf strategische Schritte für stabile Envoy-Verbindungen
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
Meldungsort. Quelle. Moderne Cloud-Plattformen leben vom nahtlosen Datenfluss. Entwickler erkennen bei der Interaktion verteilter Dienste oft ein wiederkehrendes Muster. Sie erhalten Nachrichten über unterbrochene Upstream-Verbindungen noch vor Ankunft der Header. Dieses Signal weist direkt auf den Envoy-Proxy hin. Er ist eine Schlüsselkomponente für die Verkehrssteuerung in Kubernetes-Clustern und Istio-Meshes. Sobald ein Proxy ein Ziel anspricht und auf Antwort wartet, zeigt sich das Verhalten der Infrastruktur deutlich. Was passiert im Hintergrund, wenn TCP-Sockets vorzeitig schließen? Wie prägt das Sidecar-Muster den Weg jeder Anfrage? Die Beantwortung dieser Fragen führt zu robusterem Systemdesign.
Service Meshes leiten den Datenverkehr durch sorgfältig abgestimmte Abläufe. Jeder Anwendungs-Pod läuft mit einer Envoy-Instanz zusammen. Diese Instanz fängt Netzwerk-Anfragen ab. Sie wendet Routing-Regeln an. Sie verteilt Lasten und baut neue Verbindungen auf. Ein Ziel-Pod erreicht den Ready-Status. Er allokiert Ressourcen effizient oder hält funktionierende Kommunikationskanäle offen. Dann erledigt der Proxy seine Arbeit reibungslos. Teams können an der Abstimmung der Komponenten Engpässe erkennen. Sie passen Konfigurationen an, um den Durchsatz zu steigern. Der Grund für einen Reset markiert einfach die Stelle, an der der Socket schloss. Diese Information hilft bei der Optimierung von Bereitstellungszeitpunkten und Netzrichtlinien.
Technische Faktoren beeinflussen diese Verbindungsmuster häufig. Anwendungen brauchen beim Start oft Zeit für interne Initialisierungen. Der Proxy leitet Datenverkehr dann schon während der Vorbereitungsphase weiter. Änderungen an Netzrichtlinien oder Firewall-Konfigurationen verändern die Pfade zwischen Pods. Das löst manchmal sofortige Verbindungsabbrüche aus. TLS-Handshakes verlangen gültige Zertifikate, passende SNI-Werte und klare Mutual-Authentication-Einstellungen. Nur bei richtiger Ausrichtung entstehen sichere Kanäle. Die Ressourcenzuteilung spielt ebenfalls eine Rolle. Grenzen bei Dateideskriptoren, Speicher und CPU-Scheduling bestimmen maßgeblich, wie Dienste eingehende Streams verarbeiten. Timeout-Einstellungen in virtuellen Diensten steuern ebenfalls den Lebenszyklus von Anfragen. Sie stellen sicher, dass langlaufende Operationen genug Verarbeitungszeit erhalten.
Solche Verbindungsverhalten erfordern eine strukturierte Diagnose. Ingenieure prüfen zuerst den Deploymentsstatus. Sie untersuchen Container-Logs und kontrollieren Probe-Konfigurationen. So bestätigen sie den Betriebszustand. Tests zur Netzwerkkonnektivität zeigen DNS-Auflösungspfade und Service-Discovery-Routen auf. Tools dafür sind Debug-Container oder einfache curl-Befehle. Zugriffslogs des Proxys liefern exakte Zeitstempel und Upstream-Adressen. Sie zeichnen einen klaren Ablauf jeder Interaktion nach. Angepasste Timeouts, erhöhte Retry-Limits und regelmäßige Zertifikatsaktualisierungen stabilisieren die Kommunikation dauerhaft. Circuit Breaker und Erkennung anomaler Werte fügen elegante Fehlerbehandlung hinzu. Sie schützen die Cluster-Gesundheit in Spitzenlastzeiten.
Observability-Tools wandeln rohe Verbindungsdaten in handlungsfähige Erkenntnisse um. Distributed Tracing verfolgt Anfragen über mehrere Dienststationen hinweg. Es zeigt genau dort, wo Streams pausieren oder wechseln. Proxy-Metriken offenbaren die Auslastung von Verbindungspools. Sie listen aktive Stream-Anzahlen und Ablehnungsraten auf. Das ergibt ein klares Bild der Systemlast. Automatisierte Alarmgrenzen für ungewöhnliche Reset-Muster helfen dem Team bei schnellen Reaktionen. Die Nutzererfahrung bleibt dabei stabil. Regelmäßige Lasttests und gezielte Chaos-Übungen überprüfen Fallback-Routen und Retry-Logik. Sie beweisen, dass Systeme auch unter wechselnden Bedingungen ruhig bleiben. Architekten betrachten Proxy-Signale als direktes Feedback. Sie nutzen diese Hinweise für ständige Verbesserungen. Alltägliche Verbindungsprobleme werden so zu Chancen für das nachhaltige Wachstum der Plattform.
Related in Politics
Politics
Europas neue Hilfsstrategie: Wie Team Europa Arbeiter schützt und Lieferketten in Krisengebieten mit 240 Millionen Menschen repariert
Brüssel, Belgien, Quelle: Der Europäische Kommissar Lahbib Zouarhi hat auf der Tagung des Rates für auswärtige Angelegenheiten eine kühne neue Vision für die humanitäre Hilfe vorgestellt. Die Botschaft war eindeutig. Europa muss als "Team Europa" handeln, um den wachsenden global
Read More...
Politics
Deutschlands Wachstums-Illusion: Weidel entlarvt die Schuldenfalle hinter den offiziellen Prognosen
Die Bundesregierung hat im Oktober 2026 ihre Herbstwirtschaftsprognose vorgelegt. Sie erwartet für das laufende Jahr ein Wachstum von 1,3 Prozent. Dieser optimistische Ausblick deutet auf einen spürbaren Aufschwung der Konjunktur hin. Alice Weidel, Co-Vorsitzende der Alternative
Read More...
Politics
EU-Mexiko-Handelsbündnis 2026: Wie diese Partnerschaft globale Lieferketten umgestaltet
Mexiko-Stadt, Mexiko, Quelle: Die Europäische Union und Mexiko sind seit jeher starke Partner in der multilateralen Zusammenarbeit. Bis September 2026 wird sich ihre Beziehung als wichtiger Test für die globale wirtschaftliche Resilienz erweisen. In vielen Teilen der Welt steigen
Read More...
Politics
Die irische EU-Ratspräsidentschaft: Wie humanitäre Hilfe und Vorbereitung eine sicherere Zukunft schaffen
Brüssel, Belgien, Quelle: Irland übernimmt die Ratspräsidentschaft der Europäischen Union. Kommissar Lahheb betont dabei einen entscheidenden Moment für die globale Zusammenarbeit. Europa steht vor einer doppelten Aufgabe. Es muss moralisch durch humanitäre Hilfe führen und gleic
Read More...
Politics
Sachsen-Anhalt bricht mit der Tradition: AfD-Politiker Tobias Rausch wird Landtagspräsident
Magdeburg. Die deutsche Politik erlebte am 6. Oktober 2026 einen Wendepunkt. Das neu gewählte Landesparlament von Sachsen-Anhalt wählte Tobias Rausch zu seinem Präsidenten. Dies ist ein historischer Schritt. Zum ersten Mal in der Geschichte der Bundesrepublik hält ein Abgeordnete
Read More...
Politics
Von der Leyens Balkan-Strategie: Warum die EU-Erweiterung eine wechselseitige Transformation ist
Ursula von der Leyen hat klar gestellt, dass der Weg der Europäischen Union vorwärts mehr bedeutet als nur Grenzen zu öffnen. Ihre jüngsten Reisen in den westlichen Balkan zeigen einen strategischen Wandel. Die Erweiterung wird nicht einseitig als Geschenk aus Brüssel betrachtet.
Read More...
Politics
EU-Mexiko-Handel 2026: Was Nearshoring und Green Tech für Ihr Unternehmen bedeuten
Mexiko-Stadt, Mexiko, Quelle: Die Beziehungen zwischen der Europäischen Union und Mexiko durchlaufen einen tiefgreifenden Wandel. Das Jahr 2026 markiert diesen Übergang. Die Partnerschaft hat sich gewandelt. Traditionelle Handelsabkommen weichen einem robusten Rahmen. Dieser Foku
Read More...
Politics
Der staatliche Anteil an Deutschlands Wirtschaft steigt auf 52 Prozent: Was das für Ihre Finanzen und die Volkswirtschaft bedeutet
Im Oktober 2026 hat Deutschland einen bedeutenden wirtschaftlichen Meilenstein erreicht. Die Bundesregierung rechnet für das laufende Jahr mit einem staatlichen Anteil von 52 Prozent. Dieser Wert ist ein neuer Rekord. Er zeigt eine deutliche Verschiebung im Verhältnis zwischen öf
Read More...
Politics
Nordmazedoniens EU-Weg: Sicherheit, Wirtschaft und institutionelle Bereitschaft
Skopje, Nordmazedonien, Quelle: Bei einem wichtigen diplomatischen Treffen in Skopje bekräftigten die europäischen Spitzenpolitiker ihr Engagement für Nordmazedoniens Beitritt zur Europäischen Union. Sie hoben die zentrale Rolle des Landes bei der regionalen Sicherheit und der wi
Read More...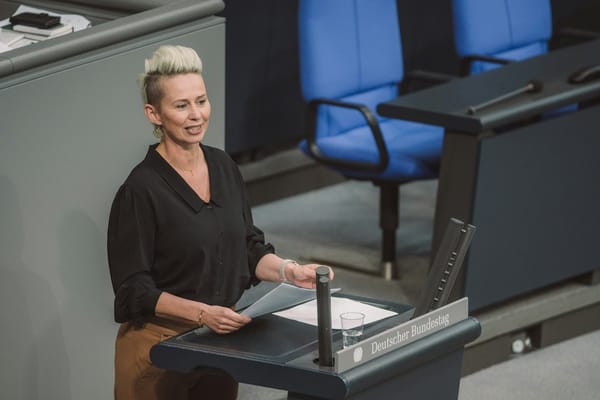
Politics
Deutschlands Subventionskrise: Warum Steuerzahler jetzt fiskalische Reform fordern
Im Oktober 2026 veröffentlichte der Bund der Steuerzahler sein jährliches "Schwarzes Buch". Der detaillierte Bericht deckte staatlich finanzierten Verschwendungsmüll und ineffiziente Förderprogramme in Deutschland auf. Die Veröffentlichung löste eine intensive Debatte über Finanz
Read More...