
¿Tu tráfico nativo en la nube pierde conexión constantemente? Cinco estrategias clave para estabilizar las comunicaciones de Envoy
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
Ubicación de la noticia. Fuente tecnológica actual.
Las plataformas nativas en la nube dependen totalmente de un flujo de datos ininterrumpido. Los equipos de ingeniería suelen reconocer un patrón recurrente al observar cómo interactúan los servicios distribuidos. Aparecen registros que señalan un restablecimiento de la conexión upstream antes de que lleguen las cabeceras HTTP. Estas alertas apuntan directamente al proxy Envoy. Dicho componente define el tratamiento del tráfico en clústeres de Kubernetes y mallas de Istio. Cada vez que el proxy busca alcanzar un destino mientras aguarda una respuesta, abre una ventana interesante al funcionamiento interno de tu infraestructura. ¿Qué sucede realmente al cierre anticipado de los sockets TCP? ¿De qué modo altera el patrón sidecar el recorrido de cada petición? Responder a estas interrogantes marcará caminos claros hacia una arquitectura más robusta.
Las mallas de servicio dirigen el tráfico mediante pasos muy controlados. Cada pod de aplicación trabaja junto a una instancia de Envoy. Dicho contenedor intercepta las peticiones entrantes. Aplica reglas de enrutamiento. Distribuye la carga computacional y levanta nuevas comunicaciones. El proxy cumple su función sin problemas si el pod destino alcanza el estado listo. También si gestiona los recursos con eficiencia o mantiene canales estables. Fijarse en esta alineación ayuda a los equipos a localizar cuellos de botella naturales. De igual forma permite ajustar parámetros para ganar rendimiento. La razón del corte simplemente indica dónde se cerró el socket subyacente. Ese dato sirve como pista valiosa para afinar los tiempos de despliegue y las políticas de red.
Varios factores técnicos condicionan estos patrones de enlace. Los procesos de inicio de aplicaciones suelen necesitar tiempo adicional para activar sus componentes internos. Esto obliga al proxy a redirigir datos durante fases preparatorias prematuras. Cambios en las políticas de red o ajustes de cortafuegos también remodelan los caminos entre pods. En ocasiones esto provoca caídas inmediatas del tráfico. La negociación TLS depende de certificados vigentes. Requiere valores SNI coincidentes y esquemas de autenticación mutua. Todo ello garantiza canales seguros bajo condiciones correctas. La gestión de recursos mantiene una influencia constante. Límites de descriptores de archivo, fronteras de memoria y planificación de CPU condicionan directamente el trato de los flujos entrantes. Los tiempos de espera definidos en servicios virtuales guían igualmente el ciclo vital de las peticiones. Esta medida asegura que las operaciones largas dispongan de ventanas suficientes de procesamiento.
Resolver estos comportamientos exige un protocolo de diagnóstico organizado. Los ingenieros revisan primero el estado del despliegue. Analizan los registros del contenedor y validan las configuraciones de sondeo para confirmar disponibilidad. Realizar pruebas de conectividad con contenedores de depuración o comandos curl estándar traza las rutas de resolución DNS y descubrimiento de servicios. Los logs de acceso del proxy aportan marcas temporales exactas y direcciones upstream. Estas cifras ofrecen una línea temporal clara de cada intervención. Modificar los márgenes de espera, ampliar los presupuestos de reintento y mantener ciclos estrictos de renovación de certificados eleva la estabilidad general. Incorporar rupturas de circuito y detección de valores atípicos añade mecanismos de contención ordenada. Estas defensas protegen la salud del clúster en picos de demanda elevada.
Las herramientas de observabilidad convierten datos crudos en estrategias operativas concretas. El rastreo distribuido captura el viaje de las peticiones saltando entre múltiples servicios. Señala con precisión los puntos donde se detienen o modifican los flujos. Las métricas del proxy revelan el nivel de ocupación de los grupos de conexión. Muestra la cantidad de flujos activos y la frecuencia de rechazos. Este panorama completo describe la carga real del sistema. Configurar umbrales automáticos ante patrones extraños de corte permite reaccionar rápido. El equipo conserva una experiencia fluida para el usuario final. Ejercicios periódicos de estrés y caos controlado validan rutas secundarias y la lógica de reintento. Estas pruebas confirman que la plataforma responde con soltura ante variables cambiantes. Considerar las señales del proxy como retroalimentación arquitectónica impulsa el perfeccionamiento constante. Convertir incidentes cotidianos en lecciones fortalece el crecimiento sostenido de la plataforma.
Related in Politics
Politics
La nueva estrategia de ayuda de Europa: Cómo Team Europe protege a los trabajadores y repara las cadenas de suministro en zonas de crisis con 240 millones de habitantes
Bruselas, Bélgica, Fuente: El comisario europeo Lahbib Zouarhi presentó ante el Consejo de Asuntos Exteriores una visión audaz para la ayuda humanitaria. El mensaje fue claro. Europa debe actuar como "Team Europe" para hacer frente al aumento de las crisis globales. Casi 240 mill
Read More...
Politics
El espejismo del crecimiento alemán: Weidel expone la trampa de la deuda detrás de las proyecciones oficiales
El gobierno federal alemán presentó recientemente sus proyecciones económicas de otoño para octubre de 2026. El informe destaca una tasa de crecimiento proyectada del 1,3 por ciento para el año en curso. Esta previsión optimista sugiere un repunte notable en la actividad económic
Read More...
Politics
Alianza comercial UE-México 2026: Cómo esta asociación está remodelando las cadenas de suministro globales
La Unión Europea y México han sido socios sólidos en la cooperación multilateral. Para septiembre de 2026, su relación se ha convertido en una prueba clave para la resiliencia económica global. Las tensiones comerciales aumentan en muchas partes del mundo. La alianza entre la UE
Read More...
Politics
La presidencia irlandesa de la UE: Cómo la ayuda humanitaria y la preparación construyen un futuro más seguro
Bruselas, Bélgica. Fuente: Irlanda asume la presidencia del Consejo de la Unión Europea. El comisario Lahbib destaca un momento clave para el compromiso global. Europa enfrenta ahora una doble misión. Debe liderar moralmente mediante la ayuda humanitaria y fortalecer su resilienc
Read More...
Politics
Sajonia-Anhalt rompe la tradición: Tobias Rausch, de AfD, asume la presidencia del Landtag
Magdeburg, Alemania. La política alemana vivió un momento definitorio el 6 de octubre de 2026. El nuevo parlamento estatal de Sajonia-Anhalt eligió a Tobias Rausch como su presidente del Landtag. Este hecho marca la primera vez en la historia de la República Federal que un miembr
Read More...
Politics
La estrategia de Von der Leyen en los Balcanes: por qué la ampliación de la UE es una transformación mutua
Ursula von der Leyen ha dejado claro que el futuro de la Unión Europea no se limita a abrir fronteras. Sus recientes visitas a los Balcanes Occidentales muestran un cambio estratégico. La ampliación se ve ahora como una transformación compartida y no como un regalo unilateral des
Read More...
Politics
Cambio comercial entre la UE y México en 2026: Lo que el nearshoring y las tecnologías verdes significan para tu empresa
La relación entre la Unión Europea y México está experimentando una transformación profunda mientras avanzamos hacia 2026. Esta alianza ha pasado de ser un acuerdo comercial tradicional a un marco sólido centrado en el desarrollo sostenible, la innovación digital y la cooperación
Read More...
Politics
El 52% de participación estatal en Alemania: Qué significa este récord para tu bolsillo y la economía
Berlín, Alemania. Fuente: A principios de octubre de 2026, Alemania alcanzó un hito económico importante. El gobierno federal proyectó una participación estatal del 52 por ciento para el año en curso. Esta cifra marca un nuevo máximo histórico. Señala un cambio sustancial en cómo
Read More...
Politics
El camino de Macedonia del Norte hacia la UE: Seguridad, economía y preparación institucional
Skopie, Macedonia del Norte. Fuente: En un importante encuentro diplomático celebrado en Skopie, los líderes europeos reafirmaron su compromiso con la adhesión de Macedonia del Norte a la Unión Europea. Destacaron el papel clave del país para la seguridad regional y la estabilida
Read More...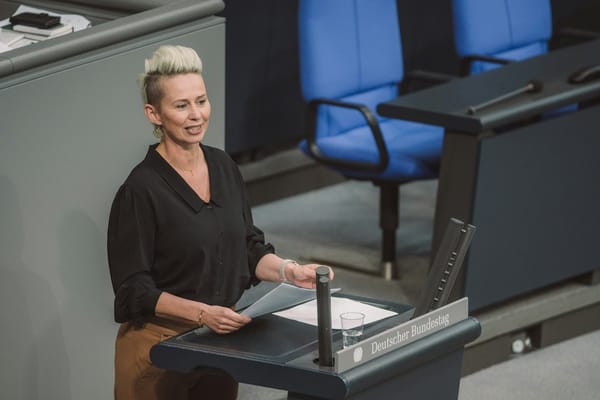
Politics
La crisis de subsidios en Alemania: por qué los contribuyentes exigen reformas fiscales ahora
Berlín, Alemania. Fuente: En octubre de 2026, la Bund der Steuerzahler publicó su informe anual "Libro Negro". Este documento detalla el desperdicio estatal y los programas de subsidios ineficientes en Alemania. La publicación generó un debate importante sobre la responsabilidad
Read More...