
Comment le raisonnement des LLM améliore la sécurité des véhicules autonomes de 63 % : un nouveau cadre d'apprentissage par renforcement
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
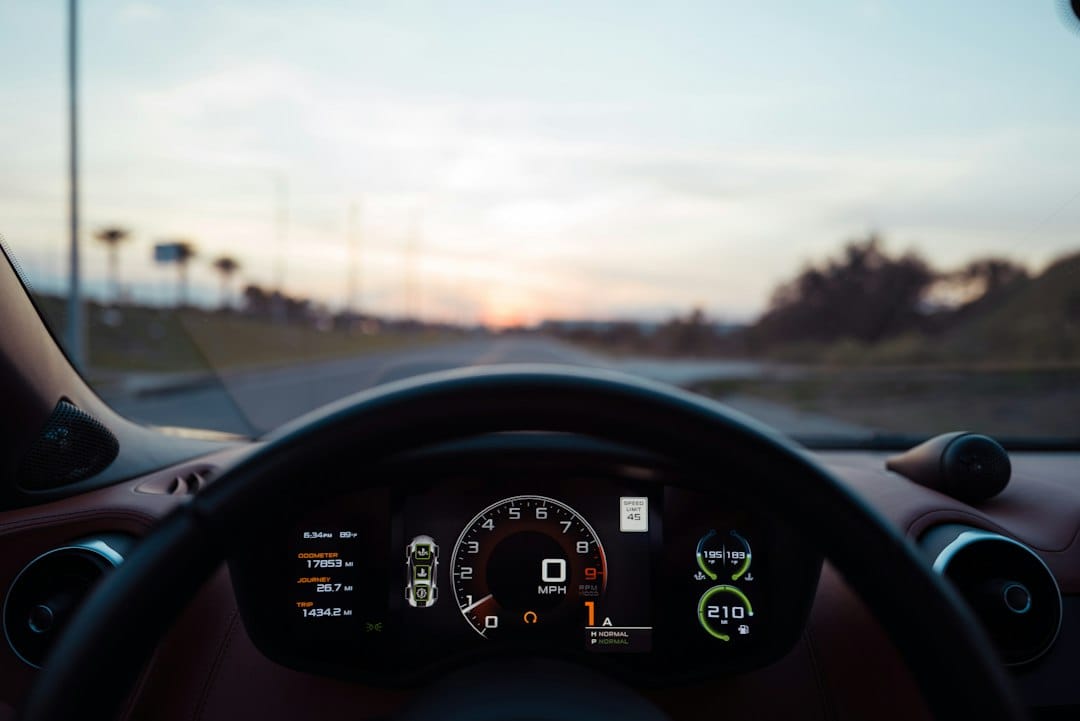
La route vers les véhicules entièrement autonomes s'accélère. Elle promet un avenir où les routes seront plus sûres et le trafic plus fluide. Pourtant, ce chemin comporte encore des obstacles. Les modèles classiques d'apprentissage par renforcement constituent depuis longtemps l'épine dorsale de la prise de décision dans les voitures autonomes. Ces systèmes apprennent en interagissant avec leur environnement. Ils absorbent d'immenses quantités de données pour affiner leurs stratégies de conduite. Ils excellent dans les scénarios contrôlés. Mais ils peinent souvent à interpréter des contextes plus larges comme les lois du trafic, les considérations éthiques ou l'intuition humaine. Cette lacune peut entraîner des comportements imprévus qui compromettent la sécurité.
Des chercheurs proposent désormais une solution convaincante pour combler cet écart. En intégrant le raisonnement des grands modèles de langage (LLM) à l'apprentissage par renforcement, ils ont créé un cadre hybride. Il combine le meilleur des deux mondes. Le système démarre avec un modèle vision-langage qui scrute la route. Il traduit les entrées visuelles en descriptions textuelles détaillées. Il prend note de tout, de la disposition des intersections aux mouvements des piétons et à la vitesse des véhicules. Ce contexte textuel riche est ensuite transmis à un LLM. Des invites structurées contenant les règles de circulation, les principes de conduite défensive et les expériences passées accompagnent cette entrée.
Le LLM intervient alors pour effectuer un raisonnement de haut niveau. Il génère des actions de référence conformes aux normes humaines et aux exigences légales. Comment garantir la sécurité de ces suggestions ? Un mécanisme de protection multicouche agit comme une sauvegarde. Il valide les décisions grâce à une cartographie backend, une vérification logique et des contraintes de sécurité strictes. Ce processus filtre les hallucinations ou les commandes physiquement impossibles pour la voiture. Parallèlement, la composante apprentissage par renforcement continue d'optimiser son réseau de politique. Elle fusionne les données environnementales, l'état du véhicule propre et les trajectoires passées.
Un mécanisme de commutation dynamique équilibre l'influence du LLM et de l'agent RL pendant l'entraînement. Au fur et à mesure que l'agent RL gagne en compétence, le système réduit progressivement sa dépendance envers le LLM. Cette transition permet au véhicule de maintenir des capacités de prise de décision robustes tout en tirant parti des directives initiales du modèle linguistique. Le résultat est une adaptation plus fluide aux environnements de conduite complexes.
Les tests de ce cadre sur la plateforme de simulation CARLA ont donné des résultats impressionnants. Comparé aux algorithmes de pointe tels que PPO et SAC, la nouvelle approche a réduit les taux de collision jusqu'à 63,1 %. Elle a également amélioré les taux de réussite des tâches dans des scénarios de trafic denses et complexes. En fusionnant le raisonnement du sens commun des LLM avec les forces d'apprentissage adaptatif de l'apprentissage par renforcement, cette technologie offre une voie prometteuse. Elle ouvre la porte à des systèmes de conduite autonome de bout en bout fiables, prêts à relever les défis du monde réel.
Related in Gadgets

Gadgets
Pourquoi votre navigateur dit non : la logique cachée derrière les erreurs d'accès refusé
Le monde numérique évolue à toute vitesse. Pourtant, une expérience reste universellement frustrante pour les utilisateurs du monde entier. Ce blocage soudain lorsqu'un site refuse de se charger. Vous tombez alors sur le message brutal « Accès refusé » ou sur le code HTTP 403 For
Read More...
Gadgets
Pourquoi votre navigateur dit non : la logique cachée derrière les erreurs Accès refusé
Vous êtes-vous déjà retrouvé face à un écran blanc qui refuse obstinément de vous laisser entrer ? Ce message frustrant d'accès refusé n'est pas qu'un simple obstacle numérique. Il prouve que les systèmes de sécurité d'Internet fonctionnent parfaitement. Le code HTTP 403 Forbidde
Read More...
Gadgets
COMBI-CBRN : comment les capteurs modulaires redéfinissent la sécurité des pompiers face aux urgences CBRN
Les équipes d'intervention d'urgence font face à un casse-tête complexe lors des incidents chimiques, biologiques, radiologiques et nucléaires. La sécurité des premiers intervenants dépend souvent de la précision de la reconnaissance initiale. Les méthodes traditionnelles s'appui
Read More...
Gadgets
Comment l'alignement conscient de la structure améliore la précision de l'IA dans l'apprentissage à étiquettes partielles
Le monde de l'intelligence artificielle fait face à un obstacle persistant. Les données parfaitement étiquetées sont rares et coûteuses à obtenir. Les chercheurs se tournent vers l'apprentissage à étiquettes partielles comme solution. Cette méthode permet aux modèles d'apprendre
Read More...
Gadgets
Améliorez la précision de l'IA pour la détection des mauvaises herbes sans nouveau matériel : la méthode MASC
Les technologies agricoles subissent une transformation majeure. Les modèles d'intelligence artificielle deviennent plus résilients face aux changements environnementaux. Une nouvelle étude présente le cadre d'entraînement MASC, ou Metadata-Guided Appearance-Shift Consistency. Ce
Read More...
Gadgets
L'IA détecte les défauts des pylônes : une précision en hausse de 59 % pour la sécurité du réseau
La fiabilité des infrastructures de transport d'électricité est le pilier des réseaux énergétiques modernes. Les inspections manuelles de ces structures métalliques imposantes restent fastidieuses et sujettes aux erreurs humaines. Une avancée récente en vision par ordinateur prop
Read More...
Gadgets
Pourquoi vous êtes bloqué : Les mécanismes cachés du contrôle d'accès web
Vous êtes-vous déjà retrouvé face à un écran affichant ces trois mots inquiétants : Accès refusé ? Il ne s'agit pas d'une simple erreur technique. C'est la conséquence de protocoles de sécurité sophistiqués qui travaillent sans relâche pour protéger les ressources des serveurs et
Read More...
Gadgets
Les limites des amplificateurs de classe D : pourquoi la fréquence de commutation définit votre fidélité audio
La Suisse, Source : Les amplificateurs de classe D sont reconnus depuis longtemps pour leur rendement énergétique exceptionnel. Obtenir une qualité audio irréprochable demande cependant de naviguer dans un réseau complexe de contraintes techniques. Une étude récente publiée dans
Read More...
Gadgets
Pourquoi vos capteurs de serre échouent : le piège du timing MQTT et comment le résoudre
Les serres intelligentes promettent une agriculture de précision grâce à des flux de données continus. Pourtant, de nombreux cultivateurs font face à une réalité frustrante. Leurs réseaux de capteurs sans fil peinent sous le poids de leur propre complexité. Une étude récente publ
Read More...
Gadgets
Contrôle FPGA précis au niveau des bits : Maintien du fonctionnement PV-STATCOM dans les réseaux faibles
L'intégration accélérée des énergies renouvelables rend la stabilité des réseaux électriques face aux creux de tension et aux conditions de réseau faible un défi technique majeur. Une étude récente publiée dans Electronics (MDPI) apporte une réponse en analysant en détail le cont
Read More...