
Pourquoi vos robots échouent à verser : la solution IA en deux étapes pour la préhension adaptée à la tâche
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
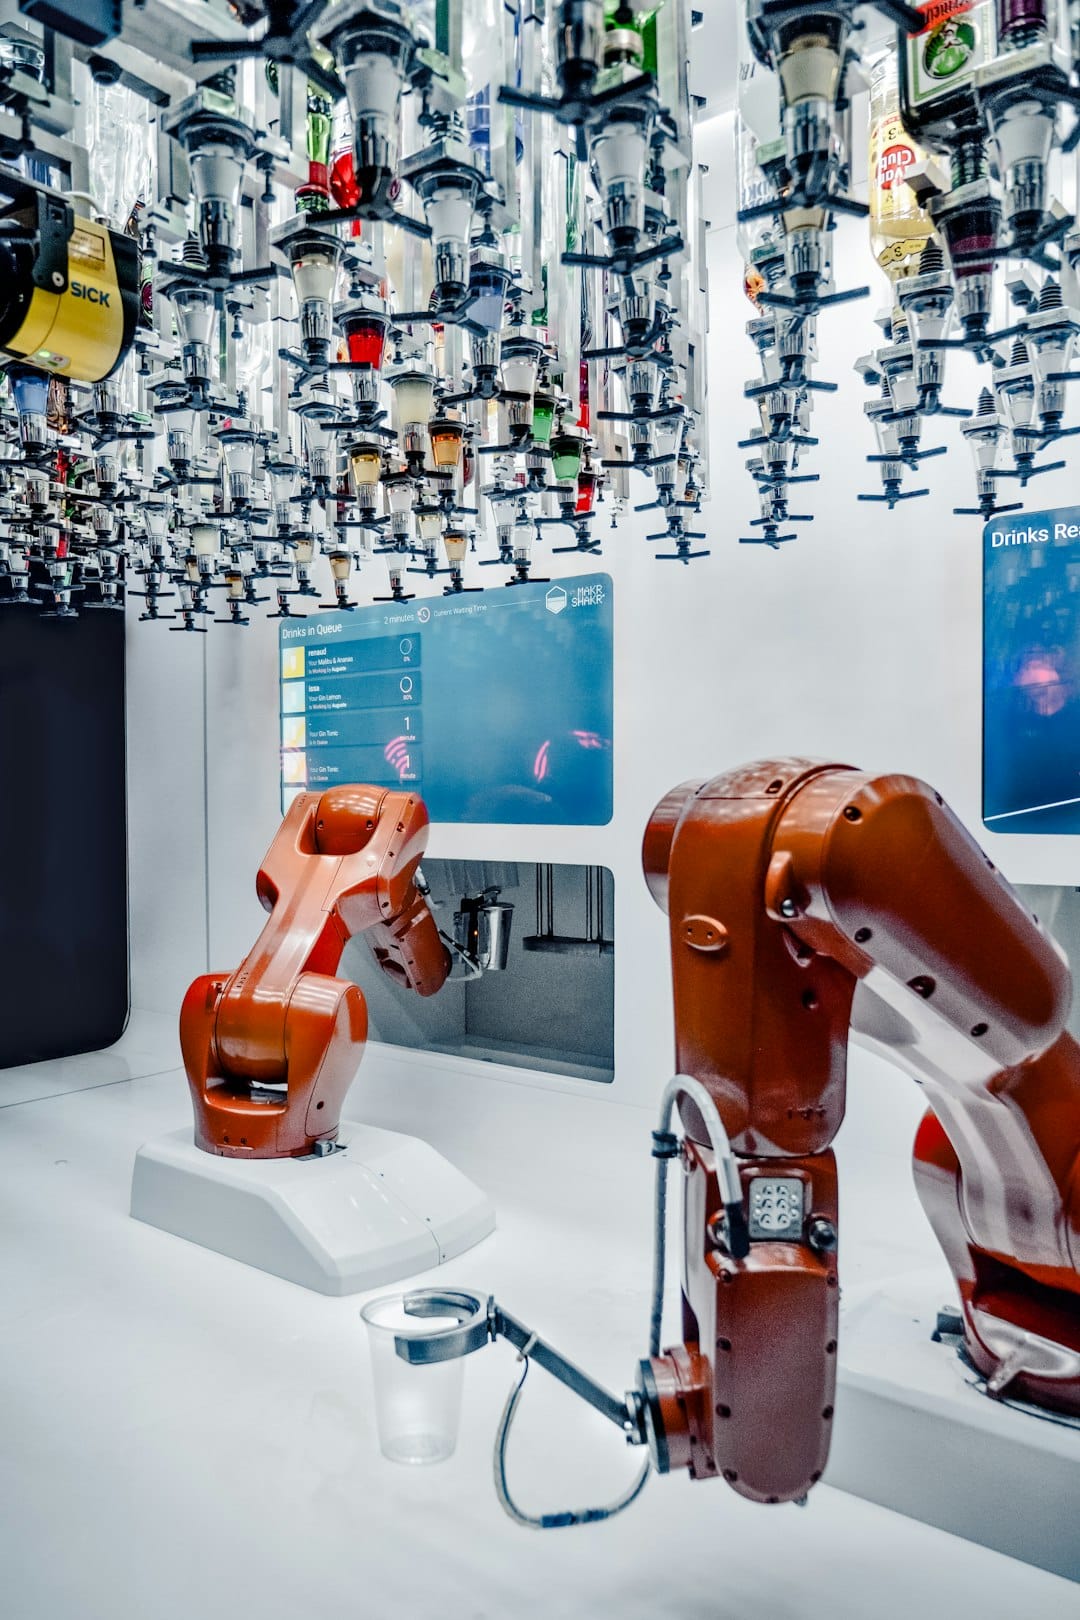
La manipulation robotique fait face à un problème persistant. Les systèmes traditionnels identifient facilement plusieurs façons de saisir un objet sur la base de sa géométrie. Ils peinent cependant à choisir la posture qui permet des actions ultérieures réussies. Prenez l’exemple d’un robot tenant parfaitement une théière mais incapable de verser car il a manqué l’orientation fonctionnelle de la poignée. Un nouveau cadre en deux étapes résout ce problème en séparant la génération de la préhension du raisonnement sémantique. Cette approche améliore considérablement la précision de la sélection conditionnée par la tâche.
L’architecture fonctionne en deux phases distinctes. Lors de la première étape, un modèle vision-langue identifie les zones pertinentes pour la tâche dans une observation RGB-D. Cela guide la segmentation et la génération de candidats de préhension plausibles à six degrés de liberté via GraspNet. Le résultat est un ensemble de propositions géométriquement valides et liées à des zones fonctionnelles spécifiques. La deuxième étape utilise ensuite un critique VLM structuré pour classer ces candidats ancrés. Elle les évalue en fonction de leur compatibilité avec la tâche visée plutôt que de se fier uniquement aux scores géométriques. Cette approche bornée empêche le modèle de générer des postures non contraintes. Il sélectionne ainsi parmi un ensemble validé d’identifiants de candidats.
Des évaluations extensives menées lors de 60 essais physiques complets ont montré un taux de réussite global de 63,3 %. Les tests couvraient des tâches telles que le ramassage et le placement aléatoires, le martelage et le versement. Des expériences de relecture contrôlée ont révélé des variations significatives de performance selon le choix du VLM. Gemini 3 Flash Preview s’est imposé comme le meilleur performer pour la localisation à l’étape 1. Il a atteint 95,0 % de précision avec la latence la plus faible. Pour le classement à l’étape 2, GPT-5.6 Sol a démontré une fiabilité supérieure. Il a obtenu un taux Top-1 valide pour la tâche de 92,9 % et a montré la plus grande cohérence lors des inférences répétées.
Cette étude met en lumière le fait que l’accomplissement physique d’une tâche et le comportement spécifique au modèle capturent différents aspects de la robustesse du système. L’analyse de sensibilité a montré que des changements dans les preuves des candidats amonts pouvaient modifier les sélections finales de préhension. Cela souligne la nécessité d’évaluer les deux étapes conjointement. En séparant l’isolement sémantique de l’audit des candidats, ce cadre offre une base plus claire pour évaluer les systèmes robotiques basés sur les VLM. Il va au-delà des simples métriques de succès pour comprendre où et pourquoi les décisions réussissent ou échouent. Cette méthodologie propose une voie évolutive pour intégrer un raisonnement de haut niveau dans le contrôle robotique de bas niveau. Elle garantit que les robots ne saisissent pas seulement les objets, mais le font d’une manière qui respecte des instructions humaines complexes.
Related in Gadgets

Gadgets
Pourquoi votre navigateur dit non : la logique cachée derrière les erreurs d'accès refusé
Le monde numérique évolue à toute vitesse. Pourtant, une expérience reste universellement frustrante pour les utilisateurs du monde entier. Ce blocage soudain lorsqu'un site refuse de se charger. Vous tombez alors sur le message brutal « Accès refusé » ou sur le code HTTP 403 For
Read More...
Gadgets
Pourquoi votre navigateur dit non : la logique cachée derrière les erreurs Accès refusé
Vous êtes-vous déjà retrouvé face à un écran blanc qui refuse obstinément de vous laisser entrer ? Ce message frustrant d'accès refusé n'est pas qu'un simple obstacle numérique. Il prouve que les systèmes de sécurité d'Internet fonctionnent parfaitement. Le code HTTP 403 Forbidde
Read More...
Gadgets
COMBI-CBRN : comment les capteurs modulaires redéfinissent la sécurité des pompiers face aux urgences CBRN
Les équipes d'intervention d'urgence font face à un casse-tête complexe lors des incidents chimiques, biologiques, radiologiques et nucléaires. La sécurité des premiers intervenants dépend souvent de la précision de la reconnaissance initiale. Les méthodes traditionnelles s'appui
Read More...
Gadgets
Comment l'alignement conscient de la structure améliore la précision de l'IA dans l'apprentissage à étiquettes partielles
Le monde de l'intelligence artificielle fait face à un obstacle persistant. Les données parfaitement étiquetées sont rares et coûteuses à obtenir. Les chercheurs se tournent vers l'apprentissage à étiquettes partielles comme solution. Cette méthode permet aux modèles d'apprendre
Read More...
Gadgets
Améliorez la précision de l'IA pour la détection des mauvaises herbes sans nouveau matériel : la méthode MASC
Les technologies agricoles subissent une transformation majeure. Les modèles d'intelligence artificielle deviennent plus résilients face aux changements environnementaux. Une nouvelle étude présente le cadre d'entraînement MASC, ou Metadata-Guided Appearance-Shift Consistency. Ce
Read More...
Gadgets
L'IA détecte les défauts des pylônes : une précision en hausse de 59 % pour la sécurité du réseau
La fiabilité des infrastructures de transport d'électricité est le pilier des réseaux énergétiques modernes. Les inspections manuelles de ces structures métalliques imposantes restent fastidieuses et sujettes aux erreurs humaines. Une avancée récente en vision par ordinateur prop
Read More...
Gadgets
Pourquoi vous êtes bloqué : Les mécanismes cachés du contrôle d'accès web
Vous êtes-vous déjà retrouvé face à un écran affichant ces trois mots inquiétants : Accès refusé ? Il ne s'agit pas d'une simple erreur technique. C'est la conséquence de protocoles de sécurité sophistiqués qui travaillent sans relâche pour protéger les ressources des serveurs et
Read More...
Gadgets
Les limites des amplificateurs de classe D : pourquoi la fréquence de commutation définit votre fidélité audio
La Suisse, Source : Les amplificateurs de classe D sont reconnus depuis longtemps pour leur rendement énergétique exceptionnel. Obtenir une qualité audio irréprochable demande cependant de naviguer dans un réseau complexe de contraintes techniques. Une étude récente publiée dans
Read More...
Gadgets
Pourquoi vos capteurs de serre échouent : le piège du timing MQTT et comment le résoudre
Les serres intelligentes promettent une agriculture de précision grâce à des flux de données continus. Pourtant, de nombreux cultivateurs font face à une réalité frustrante. Leurs réseaux de capteurs sans fil peinent sous le poids de leur propre complexité. Une étude récente publ
Read More...
Gadgets
Contrôle FPGA précis au niveau des bits : Maintien du fonctionnement PV-STATCOM dans les réseaux faibles
L'intégration accélérée des énergies renouvelables rend la stabilité des réseaux électriques face aux creux de tension et aux conditions de réseau faible un défi technique majeur. Une étude récente publiée dans Electronics (MDPI) apporte une réponse en analysant en détail le cont
Read More...