
रोबोट डालने में क्यों असफल होते हैं: कार्य-विशिष्ट पकड़ के लिए दो चरणों वाला एआई समाधान
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
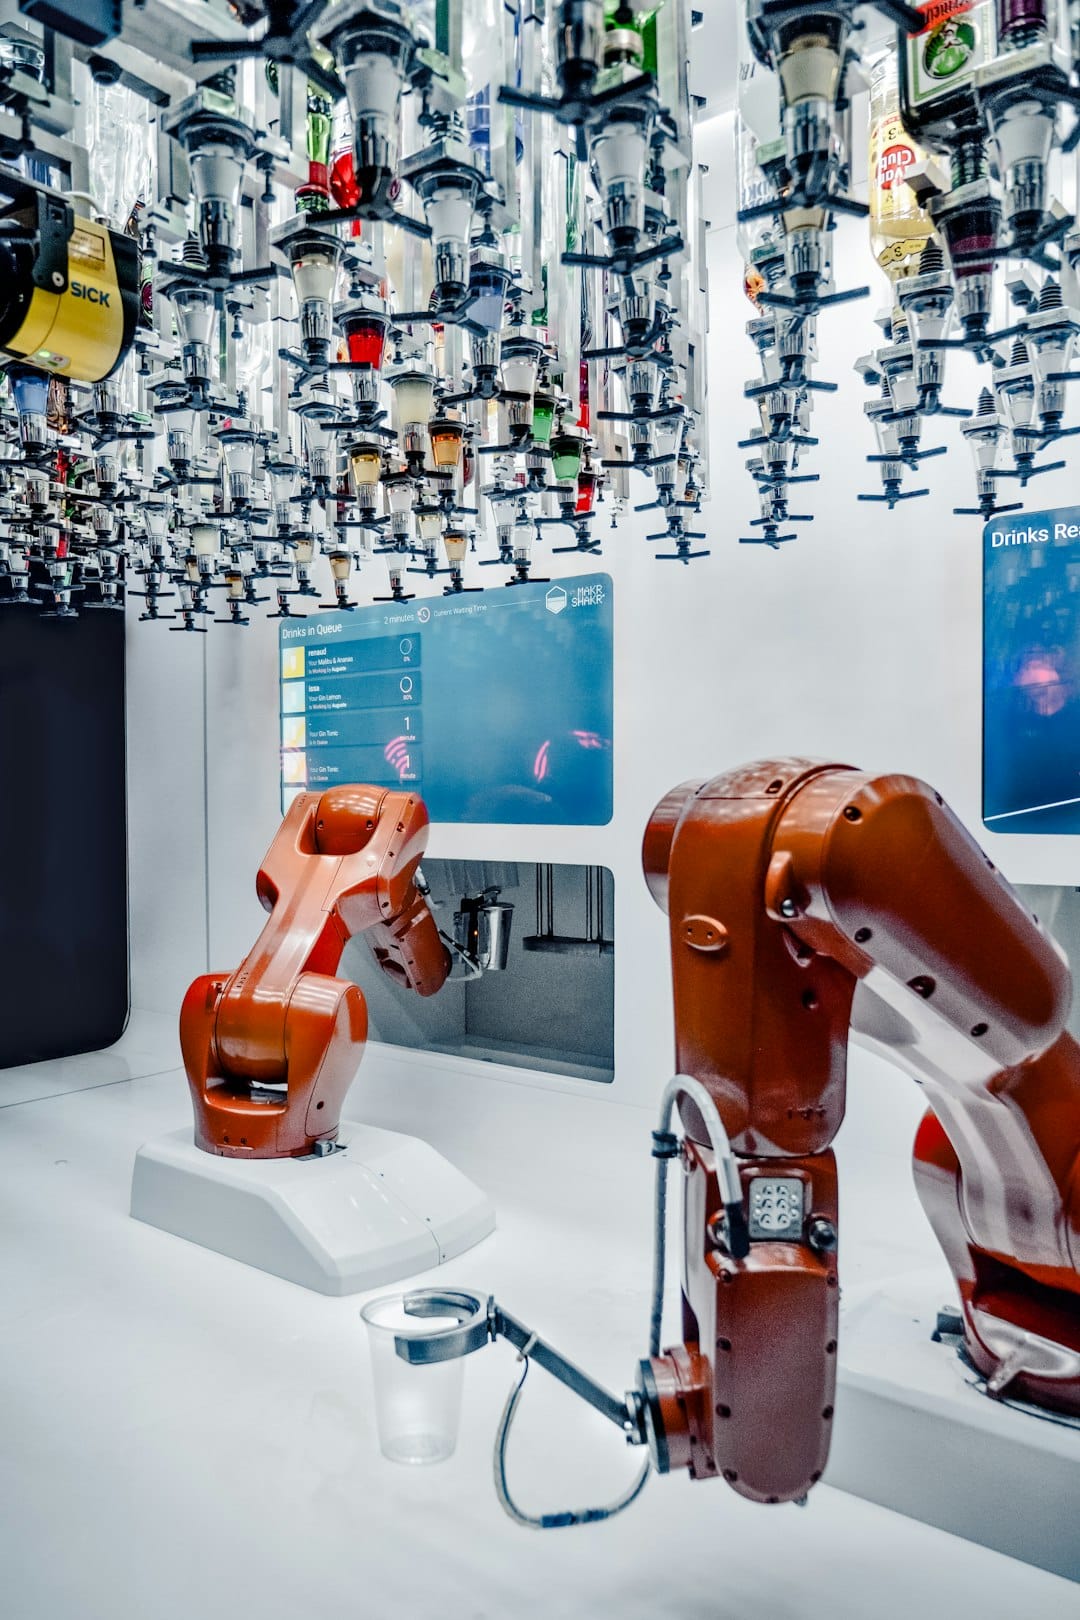
स्विस संशोधकों ने रोबोटिक निपटान की एक लंबी चल रही समस्या को सुलझाने का रास्ता निकाला है। पारंपरिक सिस्टम ज्यामिति के आधार पर किसी वस्तु को पकड़ने के कई तरीके आसानी से पहचान लेते हैं। फिर भी वे अक्सर उन मुद्राओं का चयन करने में नाकाम रहते हैं जो आगे की प्रक्रियाओं को सफल बना सकती हैं। उदाहरण के लिए, एक रोबोट कलशी को बिल्कुल सही ढंग से पकड़े रख सकता है। लेकिन यदि वह हैंडल की सही दिशा नहीं समझ पाता तो चाय या पानी नहीं डाल सकता। नया दो चरणों वाला फ्रेमवर्क इस समस्या को हल करता है। यह पकड़ बनाने की प्रक्रिया को अर्थपूर्ण तर्क से अलग कर देता है। इससे कार्य की शर्तों के अनुसार सही चयन की दर काफी बढ़ जाती है।
इस आर्किटेक्चर में समस्या को हल करने के लिए दो स्पष्ट चरण काम करते हैं। पहले चरण में एक विजन-भाषा मॉडल RGB-D छवि में ऐसे हिस्सों को पहचानता है जो कार्य के लिए जरूरी हैं। यह सेगमेंटेशन और ग्रैस्पनेट के जरिए संभावित 6-DoF पकड़ के उम्मीदवारों को जनरेट करने में मदद करता है। परिणामस्वरूप मिले सुझाव ज्यामितीय रूप से ठीक होते हैं। ये सुझाव विशिष्ट कार्यात्मक क्षेत्रों से भी जुड़े होते हैं। दूसरे चरण में एक संरचित VLM क्रिटिक इन उम्मीदवारों को रैंक करता है। यह इंतहाई कार्य से संगतता के आधार पर उनका मूल्यांकन करता है। यह सिर्फ ज्यामितीय स्कोर पर निर्भर नहीं रहता। यह सीमित दृष्टिकोण मॉडल को बिना नियंत्रण वाली मुद्राएं बनाने से रोकता है। इसके बजाय यह मान्यता प्राप्त उम्मीदवारों के ID से सही विकल्प चुनता है।
60 भौतिक परीक्षणों के व्यापक मूल्यांकन से पता चला कि कुल कार्य सफलता दर 63.3 प्रतिशत थी। इन परीक्षणों में बेतरतीब पकड़ और रखना, हथौड़ा मारना और पीना जैसे कार्य शामिल थे। नियंत्रित पुनः प्रयोगों से पता चला कि VLM के चुनाव के आधार पर प्रदर्शन में काफी बदलाव आता है। Stage 1 के स्थान निर्धारण के लिए Gemini 3 Flash Preview सबसे अच्छा साबित हुआ। इसने 95.0 प्रतिशत सटीकता हासिल की। साथ ही इसमें सबसे कम लेटेंसी भी थी। Stage 2 के रैंकिंग के लिए GPT-5.6 Sol ने बेहतरीन विश्वसनीयता दिखाई। इसने 92.9 प्रतिशत टॉप-1 कार्य-मान्य दर दर्ज की। बार-बार इनफरेंस में इसकी स्थिरता सबसे अधिक थी।
इस अध्ययन से यह स्पष्ट होता है कि भौतिक कार्य पूरा करना और मॉडल का व्यवहार सिस्टम की मजबूती के अलग-अलग पहलुओं को दर्शाते हैं। संवेदनशीलता विश्लेषण से पता चला कि ऊपरी चरण में उम्मीदवारों के सबूतों में थोड़ी सी बदलाव भी अंतिम पकड़ के चयन को बदल सकता है। इससे दोनों चरणों को साथ में आंकने की जरूरत स्पष्ट होती है। अर्थविवेचन को उम्मीदवारों की जांच से अलग करके यह फ्रेमवर्क VLM-आधारित रोबोटिक सिस्टम के आकलन के लिए एक स्पष्ट आधार प्रदान करता है। यह सरल सफलता मापदंडों से आगे बढ़कर यह समझने में मदद करता है कि निर्णियां कहाँ और क्यों सफल या असफल होती हैं। यह विधि उच्च स्तरीय तर्क को निम्न स्तरीय रोबोटिक नियंत्रण में एकीकृत करने का एक स्केलेबल मार्ग प्रस्तुत करती है। यह सुनिश्चित करता है कि रोबोट न केवल वस्तुओं को पकड़ें। बल्कि वे इसे ऐसे करें कि जटिल मानव निर्देश पूरे हों।
Related in Gadgets

Gadgets
ब्राउज़र 'ना' क्यों कहता है: एक्सेस डेनाइड त्रुटि के पीछे की छिपी तर्कशक्ति
डिजिटल दुनिया बहुत तेजी से चलती है। फिर भी एक अनुभव हर जगह उपयोगकर्ताओं के लिए नाराजगी भरा रहता है। जब कोई वेबसाइट लोड होने से मना कर देती है तो अचानक रुक जाना। आप कठोर संदेश देखते हैं 'एक्सेस डेनाइड' या HTTP 403 फॉरबिडेन कोड। यह कोई यादृच्छिक त्रुटि नहीं है। यह आधुनिक वेब इंफ्रा
Read More...
Gadgets
COMBI-CBRN: मॉड्यूलर सेंसर CBRN आपात स्थितियों में फायरफाइटर सुरक्षा को कैसे पुनर्परिभाषित कर रहे हैं
रासायनिक, जैविक, विकिरण और नाभिकीय (CBRN) घटनाओं से निपटते समय आपातकालीन प्रतिक्रिया टीमों के सामने एक जटिल चुनौती होती है। पहली प्रतिक्रिया देने वालों की सुरक्षा अक्सर प्रारंभिक जांच की सटीकता पर निर्भर करती है। पुरानी विधियां अक्सर अलग-अलग डिटेक्शन उपचारों पर निर्भर रहती हैं। इ
Read More...
Gadgets
आंशिक-लेबल लर्निंग में संरचना-अवेयर अलाइनमेंट से AI की सटीकता कैसे बढ़ती है
कृत्रिम बुद्धिमत्ता के क्षेत्र में एक पुरानी चुनौती मौजूद है। बिल्कुल सही लेबल वाले डेटा को प्राप्त करना दुर्लभ और महंगा होता है। शोधकर्ताओं ने इसका हल आंशिक-लेबल लर्निंग में खोजा है। इस विधि से मॉडल्स धुंधली निगरानी से सीख सकते हैं। हर उदाहरण के साथ लेबल्स का एक समूह दिया जाता ह
Read More...
Gadgets
बिना नए हार्डवेयर के जड़ी बूटी पहचान एआई की सटीकता बढ़ाएं: MASC विधि
कृषि प्रौद्योगिकी में क्रांतिकारी बदलाव आ रहा है। कृत्रिम बुद्धिमत्ता मॉडल अब पर्यावरणीय परिवर्तनों के प्रति अधिक सहनशील हो गए हैं। एक नई अध्ययन ने 'मेटाडेटा-गाइडेड अपियरेंस-शिफ्ट कॉन्सिस्टेंसी' या MASC का परिचय दिया है। यह एक ट्रेनिंग फ्रेमवर्क है जो बिना किसी हार्डवेयर अपग्रेड
Read More...
Gadgets
AI ट्रांसमिशन टावर की कमियों को पहचानता है। ग्रिड सुरक्षा में सटीकता में 59% की बढ़ोतरी
आधुनिक ऊर्जा ग्रिड विद्युत प्रसारण बुनियादी ढांचे की विश्वसनीयता पर निर्भर करते हैं। ऊंची स्टील संरचनाओं का मैन्युअल निरीक्षण मेहनत वाला काम है और इसमें मानवीय त्रुटियों की संभावना रहती है। कंप्यूटर विजन तकनीक में आए हालिया सुधार उच्च वोल्टेज ट्रांसमिशन टावरों में संरचनात्मक कमिय
Read More...
Gadgets
क्लास-डी एम्पलीफायर की सीमाएं: स्विचिंग फ्रीक्वेंसी आपके ऑडियो गुणवत्ता को कैसे निर्धारित करती है
स्विट्जरलैंड, स्रोत: क्लास-डी एम्पलीफायरों को लंबे समय से अपनी अद्भुत ऊर्जा दक्षता के लिए जाना जाता है। फिर भी निखरी हुई ऑडियो गुणवत्ता प्राप्त करना तकनीकी बाधाओं के जटिल नेटवर्क से गुजरना आवश्यक बनाता है। इलेक्ट्रॉनिक्स (MDPI) में प्रकाशित एक नई अध्ययन ने फुल-ब्रिज क्लास-डी स्टे
Read More...
Gadgets
बिट-एक्यूरेट एफपीजीए कंट्रोल: कमजोर ग्रिड में पीवी-स्टैटकॉम की विश्वसनीय राइड-थ्रू
नवीकरणीय ऊर्जा के समावेश तेज हो रहा है। इससे ऐसे पावर ग्रिडों की स्थिरता चुनौतीपूर्ण बन गई है जहाँ वोल्टेज सैग और कमजोर ग्रिड की स्थितियां होती हैं। इलेक्ट्रॉनिक्स (एमडीपीआई) पत्रिका में प्रकाशित एक नई अध्ययन ने इस समस्या का हल निकाला है। यह अध्ययन फोटोवोल्टिक स्टैटिक सिंक्रोनस क
Read More...
Gadgets
Fed-PriLoRA: निजी फेडरेटेड लर्निंग के माध्यम से LLMs के लिए संचार में 99.95% की कमी
स्वास्थ्य और वित्त जैसे संवेदनशील क्षेत्रों में बड़े भाषा मॉडलों (LLMs) का उपयोग बढ़ रहा है। इससे डेटा गोपनीयता को सुनिश्चित करने की तीव्र जरूरत पैदा हुई है। फेडरेटेड लर्निंग डिवाइस पर ही मॉडल ट्रेन करने की अनुमति देती है। इसमें कच्चा डेटा शेयर नहीं होता। फिर भी, विशाल मॉडल्स को
Read More...
Gadgets
सऊदी शोधकर्ताओं ने भौतिकी-आधारित एआई से नवीकरणीय ग्रिड की अस्थिरता का हल निकाला
जद्दह, सऊदी अरब, स्रोत: विश्व ऊर्जा क्षेत्र तेजी से पवन और फोटोवोल्टिक स्रोतों की ओर बढ़ रहा है। इस बदलाव के साथ एक नई चुनौती भी सामने आई है। नवीकरणीय ऊर्जा उत्पादन में स्वाभाविक उतार-चढ़ाव ग्रिड की स्थिरता को खतरा पहुंचा सकते हैं। परंपरागत पूर्वानुमान विधियां अक्सर जटिल भौतिक सी
Read More...
Gadgets
AI सर्किट डिज़ाइन: इंजीनियर इलेक्ट्रॉनिक्स में नवाचार को कैसे तेज कर रहे हैं
इलेक्ट्रॉनिक इंजीनियरिंग की दुनिया में एक बड़ा बदलाव आ रहा है। अब कृत्रिम बुद्धिमत्ता सर्किट आर्किटेक्चर के डिज़ाइन का मुख्य हिस्सा बन गई है। उपभोक्ता छोटे, तेज़ और ऊर्जा-कुशल उपकरण चाहते हैं। पारंपरिक मानुषी विधियां आधुनिक सिस्टम की जटिलता को संभालने में पीछे रह रही हैं। यह परिव
Read More...