
Por que seu robô falha ao despejar: A correção de IA em duas etapas para preensão específica de tarefas
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
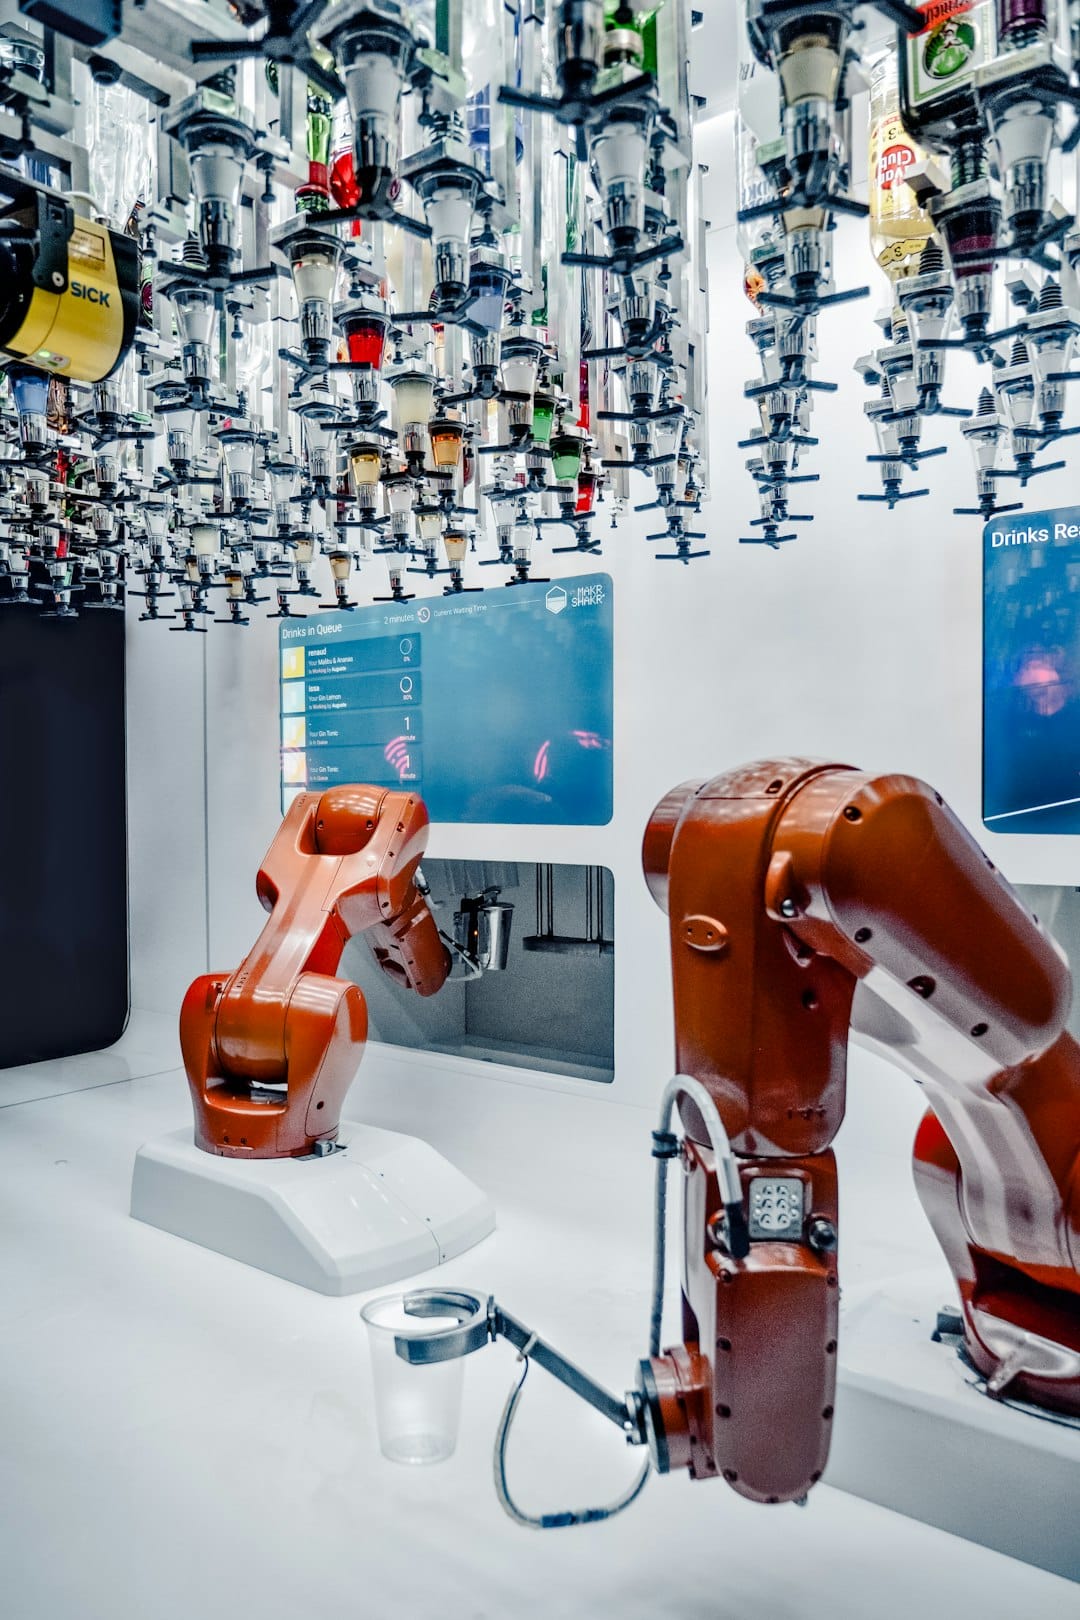
A manipulação robótica sempre enfrentou um problema específico. Sistemas tradicionais conseguem identificar facilmente várias formas de segurar um objeto apenas com base na geometria. No entanto, eles frequentemente falham ao escolher a postura que permite ações bem-sucedidas depois disso. Imagine um robô segurando uma chaleira perfeitamente mas incapaz de despejar água porque perdeu a orientação funcional da alça. Um novo framework em duas etapas resolve isso separando a geração da preensão do raciocínio semântico. Essa abordagem melhora significativamente a precisão na seleção condicionada à tarefa.
A arquitetura opera em duas fases distintas para resolver esse problema. Na Etapa 1, um Modelo de Linguagem e Visão identifica regiões relevantes para a tarefa dentro de uma observação RGB-D. Isso orienta a segmentação e a geração de candidatos plausíveis de preensão em 6 graus de liberdade por meio do GraspNet. O resultado é um conjunto de propostas que são geometricamente sólidas e vinculadas a áreas funcionais específicas. A Etapa 2 então usa um crítico VLM estruturado para classificar esses candidatos fundamentados. Ele os avalia com base na compatibilidade com a tarefa pretendida, em vez de depender apenas de escores geométricos. Essa abordagem limitada impede que o modelo gere posturas sem restrições. Em vez disso, ele seleciona a partir de um conjunto validado de IDs de candidatos.
Avaliações extensas em 60 testes físicos completos do sistema demonstraram uma taxa de sucesso geral na tarefa de 63,3%. Os testes cobriram tarefas como pegar e colocar aleatório, bater com martelo e despejar. Experimentos controlados de replay revelaram variações significativas no desempenho dependendo da escolha do VLM. O Gemini 3 Flash Preview saiu como o melhor performer para a localização na Etapa 1. Ele alcançou 95,0% de precisão com a menor latência. Para a classificação na Etapa 2, o GPT-5.6 Sol demonstrou confiabilidade superior. Ele garantiu uma taxa Top-1 válida para tarefas de 92,9% e mostrou a maior consistência em inferências repetidas.
Este estudo destaca que a conclusão de tarefas físicas e o comportamento específico dos modelos capturam aspectos diferentes da robustez do sistema. A análise de sensibilidade mostrou que mudanças nas evidências de candidatos anteriores podem alterar as seleções finais de preensão. Isso enfatiza a necessidade de avaliar ambas as etapas juntas. Ao separar o isolamento semântico da auditoria de candidatos, este framework fornece uma base mais clara para avaliar sistemas robóticos baseados em VLM. Ele vai além das métricas simples de sucesso para entender onde e por que as decisões têm sucesso ou falham. Esta metodologia oferece um caminho escalável para integrar raciocínio de alto nível ao controle robótico de baixo nível. Ela garante que os robôs não apenas peguem objetos, mas o façam de maneira que cumpra instruções humanas complexas.
Related in Gadgets

Gadgets
Por que seu navegador diz não: a lógica oculta por trás dos erros de acesso negado
O mundo digital avança rapidamente. Ainda assim, há uma experiência que continua frustrante para usuários em todo o lugar. Aquela parada súbita quando um site se recusa a carregar. Você vê a mensagem nítida 'Acesso Negado' ou o código HTTP 403 Forbidden. Isso não é apenas um erro
Read More...
Gadgets
Por que seu navegador diz não: a lógica oculta por trás dos erros de acesso negado
Você já ficou encarando uma tela em branco que simplesmente se recusa a deixar você entrar? A mensagem frustrante de 'Acesso Negado' é mais do que um simples obstáculo digital. Ela indica que os sistemas de segurança da internet estão funcionando exatamente como deveriam. Quando
Read More...
Gadgets
COMBI-CBRN: Como sensores modulares estão redefinindo a segurança dos bombeiros em emergências CBRN
Equipes de resposta a emergências enfrentam um desafio complexo ao lidar com incidentes químicos, biológicos, radiológicos e nucleares. A segurança dos primeiros socorros depende muito da precisão do reconhecimento inicial. Os métodos tradicionais costumam usar dispositivos de de
Read More...
Gadgets
Como o Alinhamento Consciente da Estrutura Aumenta a Precisão da IA no Aprendizado com Rótulos Parciais
O mundo da inteligência artificial enfrenta um obstáculo persistente. Dados perfeitamente rotulados são raros e caros para obter. Os pesquisadores voltaram-se para o aprendizado com rótulos parciais como solução. Esse método permite que os modelos aprendam com supervisão ambígua.
Read More...
Gadgets
Melhore a precisão da IA para detecção de ervas daninhas sem novo hardware: o método MASC
A tecnologia agrícola passa por uma grande transformação. Os modelos de inteligência artificial estão se tornando mais resistentes às mudanças ambientais. Um novo estudo apresenta o MASC (Metadata-Guided Appearance-Shift Consistency). Trata-se de um framework de treinamento que m
Read More...
Gadgets
IA detecta falhas em torres de transmissão e aumenta em 59% a precisão na segurança da rede
As redes de energia modernas dependem da confiabilidade da infraestrutura de transmissão elétrica. As inspeções manuais das enormes estruturas de aço continuam sendo trabalhosas e sujeitas a erros humanos. Um recente avanço na tecnologia de visão computacional oferece uma solução
Read More...
Gadgets
Por que você está bloqueado: a mecânica oculta do controle de acesso web
Você já ficou encarando uma tela e viu aquelas três palavras ameaçadoras: Acesso Negado? Isso não é apenas um defeito técnico. É o resultado de protocolos de segurança sofisticados trabalhando arduamente para proteger os recursos do servidor e dados sensíveis. Esse fenômeno é um
Read More...
Gadgets
Limites dos amplificadores Classe-D: Por que a frequência de chaveamento define sua fidelidade sonora
Os amplificadores Classe-D são reconhecidos há muito tempo por sua impressionante eficiência energética. No entanto, alcançar uma qualidade de áudio impecável exige navegar por uma rede complexa de restrições técnicas. Um estudo recente publicado na revista Electronics (MDPI) apr
Read More...
Gadgets
Por que seus sensores de estufa falham: a armadilha do tempo no MQTT e como corrigi-la
Suíça, Fonte: As estufas inteligentes prometem agricultura de precisão por meio de fluxos contínuos de dados. No entanto, muitos produtores enfrentam uma realidade frustrante onde redes de sensores sem fio falham sob o peso de sua própria complexidade. Um estudo recente na revist
Read More...
Gadgets
Fed-PriLoRA: Como o Aprendizado Federado Privado Reduz a Comunicação em 99,95% para Grandes Modelos de Linguagem
A integração de Grandes Modelos de Linguagem em setores sensíveis como saúde e finanças criou uma demanda urgente por mecanismos robustos de privacidade de dados. O aprendizado federado permite treinar modelos em dispositivos descentralizados sem compartilhar dados brutos. No ent
Read More...