
LLM-Logik steigert die Sicherheit autonomer Fahrzeuge um 63 Prozent: Ein neues RL-Framework
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
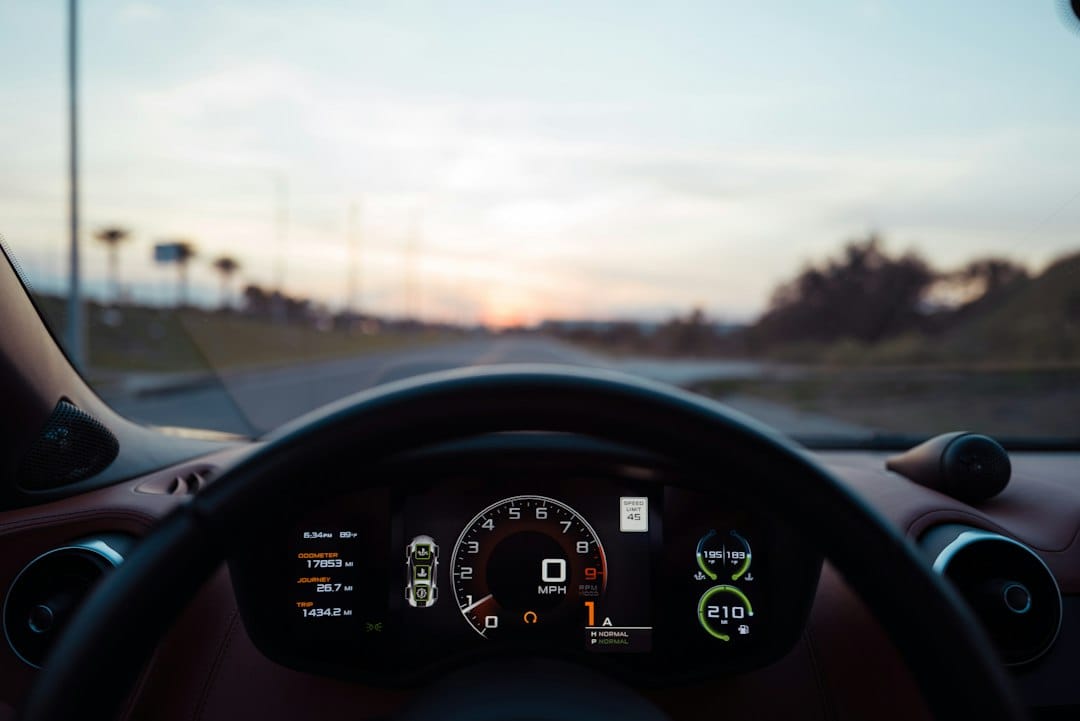
Die Entwicklung hin zu voll autonomen Fahrzeugen schreitet rasch voran. Sie verspricht eine Zukunft mit sichereren Straßen und einem effizienteren Verkehrsfluss. Der Weg dorthin ist jedoch nicht ohne Hindernisse. Traditionelle Reinforcement-Learning-Modelle bilden seit Langem das Rückgrat der Entscheidungsfindung in selbstfahrenden Autos. Diese Systeme lernen durch Interaktion mit ihrer Umgebung. Sie verarbeiten enorme Datenmengen, um ihre Fahrstrategien zu verfeinern. In kontrollierten Szenarien schneiden sie hervorragend ab. Oft scheitern sie jedoch daran, breitere Kontexte wie Verkehrsregeln, ethische Fragen oder menschliche Intuition zu erfassen. Diese Lücke kann zu unvorhersehbarem Verhalten führen, das die Sicherheit gefährdet.
Forscher haben nun eine überzeugende Lösung entwickelt, die diese Kluft überbrückt. Durch die Integration von Large-Language-Model-Logik mit Reinforcement Learning entstand ein hybrides Framework. Es kombiniert das Beste aus beiden Welten. Das System beginnt mit einem Vision-Language-Modell. Es scannt die Straße vor dem Fahrzeug und übersetzt visuelle Eingaben in detaillierte natürliche Sprachbeschreibungen. Es erfasst alles von Kreuzungsstrukturen bis hin zu Fußgängerbewegungen und Fahrzeuggeschwindigkeiten. Dieser reiche textliche Kontext wird zusammen mit strukturierten Prompts an ein LLM weitergeleitet. Diese Prompts enthalten Verkehrsregelungen, Prinzipien defensiven Fahrens und historische Fahrerfahrungen.
Das LLM übernimmt die hochrangige Logik. Es generiert Referenzaktionen, die sich an menschlichen Normen und gesetzlichen Anforderungen orientieren. Doch wie stellen wir sicher, dass diese Vorschläge sicher sind? Eine mehrschichtige Schutzmechanismus dient als Sicherheitsnetz. Es validiert Entscheidungen durch Backend-Mapping, Logiküberprüfung und strenge Sicherheitsbeschränkungen. Dieser Prozess filtert Halluzinationen oder Befehle heraus, die für das Auto physisch unmöglich wären. Parallel dazu optimiert die Reinforcement-Learning-Komponente ihr Policy-Netzwerk weiter. Dazu verschmilzt sie Umgebungsdaten, den Zustand des eigenen Fahrzeugs und vergangene Trajektorien.
Ein dynamischer Umschalte Mechanismus balanciert den Einfluss des LLM und des RL-Agenten während des Trainings. Wenn der RL-Agent immer kompetenter wird, reduziert das System schrittweise seine Abhängigkeit vom LLM. Dieser Übergang ermöglicht es dem Fahrzeug, robuste Entscheidungsfähigkeiten beizubehalten. Gleichzeitig nutzt es die anfängliche Führung durch das Sprachmodell. Das Ergebnis ist eine flüssigere Anpassung an komplexe Fahrumgebungen.
Tests dieses Frameworks auf der CARLA-Simulationsplattform erzielten beeindruckende Ergebnisse. Im Vergleich zu State-of-the-Art-Algorithmen wie PPO und SAC reduzierte der neue Ansatz die Kollisionsraten um bis zu 63,1 Prozent. Er verbesserte auch die Erfolgsquoten bei Aufgaben in dichtem und komplexem Verkehr. Durch die Verbindung der gesunden Menschenverstand-Logik von LLMs mit den adaptiven Lernstärken von Reinforcement Learning bietet diese Technologie einen vielversprechenden Weg. Er führt zu zuverlässigen End-to-End-autonomen Fahrsystemen, die bereit sind, den Herausforderungen der realen Welt zu begegnen.
Related in Gadgets

Gadgets
Warum Ihr Browser Nein sagt: Die verborgene Logik hinter Zugriffsverweigerungen
Die digitale Welt dreht sich rasant. Doch eine Erfahrung bleibt für Nutzer weltweit gleichermaßen frustrierend. Der plötzliche Stopp, wenn eine Website nicht lädt. Sie sehen die klare Meldung „Zugriff verweigert“ oder den HTTP-Code 403 Forbidden. Das ist kein zufälliger Fehler. E
Read More...
Gadgets
Warum Ihr Browser Nein sagt: Die verborgene Logik hinter Zugriffsverweigerungen
Haben Sie schon einmal auf einen leeren Bildschirm gestarrt, der sich einfach nicht öffnen ließ? Diese frustrierende Fehlermeldung "Zugriff verweigert" ist mehr als nur ein digitales Hindernis. Sie zeigt an, dass die Sicherheitssysteme des Internets genau so funktionieren, wie si
Read More...
Gadgets
COMBI-CBRN: Wie modulare Sensoren die Sicherheit von Feuerwehrleuten bei CBRN-Einsätzen neu definieren
Einsatzkräfte stehen bei chemischen, biologischen, radiologischen und nuklearen Zwischenfällen vor einer komplexen Herausforderung. Die Sicherheit der Retter hängt oft von der Genauigkeit der ersten Aufklärung ab. Herkömmliche Methoden nutzen meist separate Detektoren. Das führt
Read More...
Gadgets
Wie strukturaware Ausrichtung die KI-Genauigkeit beim Partial-Label-Learning steigert
Die künstliche Intelligenz steht vor einem hartnäckigen Problem. Perfekt annotierte Daten sind selten und teuer in der Beschaffung. Forscher haben daher das Partial-Label-Learning als Lösung entwickelt. Diese Methode ermöglicht es Modellen, aus mehrdeutiger Supervision zu lernen.
Read More...
Gadgets
MASC-Methode steigert die Genauigkeit der Unkrauterkennung ohne neue Hardware
Die Agrartechnologie durchläuft einen tiefgreifenden Wandel. Künstliche Intelligenz-Modelle werden zunehmend unempfindlicher gegenüber Umweltveränderungen. Eine neue Studie stellt das MASC-Framework vor. Der Name steht für Metadata-Guided Appearance-Shift Consistency. Dieser Trai
Read More...
Gadgets
KI erkennt Mängel an Strommasten: Präzisionsgewinn von 59 Prozent für die Netzsicherheit
Moderne Energieversorgungsnetze sind auf die Zuverlässigkeit ihrer Hochspannungsinfrastruktur angewiesen. Manuelle Inspektionen der massiven Stahlkonstruktionen sind arbeitsintensiv und fehleranfällig. Ein Durchbruch in der Computervision-Technologie bietet nun eine transformativ
Read More...
Gadgets
Wie fehlerbewusste HIL-Verifikation die AUTOSAR-Timing-Konformität in modernen ECUs sichert
Die Komplexität der Automobilelektronik steigt stetig. Daher ist die Sicherheitsintegrität von elektronischen Steuergeräten (ECUs) nach Normen wie ISO 26262 zu einer obersten Priorität geworden. Die funktionale Korrektheit wird zwar routinemäßig geprüft. Doch die zeitliche Korrek
Read More...
Gadgets
Grenzen von Class-D-Verstärkern: Warum die Schaltfrequenz die Audioqualität bestimmt
Class-D-Verstärker sind seit langem für ihre beeindruckende Energieeffizienz bekannt. Eine kristallklare Audioqualität erfordert jedoch das Navigieren durch ein komplexes Netz technischer Einschränkungen. Eine aktuelle Studie in der Zeitschrift Electronics (MDPI) bietet einen neu
Read More...
Gadgets
Warum Ihre Gewächshaus-Sensoren ausfallen: Das MQTT-Timing-Problem und wie Sie es lösen
Schweiz, Quelle: Smarte Gewächshäuser versprechen präzise Landwirtschaft durch kontinuierliche Datenströme. Viele Landwirte stehen jedoch vor einer frustrierenden Realität. Drahtlose Sensornetze scheitern oft an der eigenen Komplexität. Eine aktuelle Studie im Fachblatt Electroni
Read More...
Gadgets
Bitgenaue FPGA-Steuerung: Zuverlässiger PV-STATCOM-Betrieb in schwachen Netzen
Die Integration erneuerbarer Energien schreitet voran. Die Stabilität von Stromnetzen bei Spannungseinbrüchen und unter schwachen Netzbedingungen ist zu einer kritischen ingenieurtechnischen Herausforderung geworden. Eine aktuelle Studie im Fachjournal Electronics (MDPI) behandel
Read More...