
Warum Roboter beim Schütten scheitern: Die Zwei-Phasen-KI-Lösung für aufgabenbezogenes Greifen
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
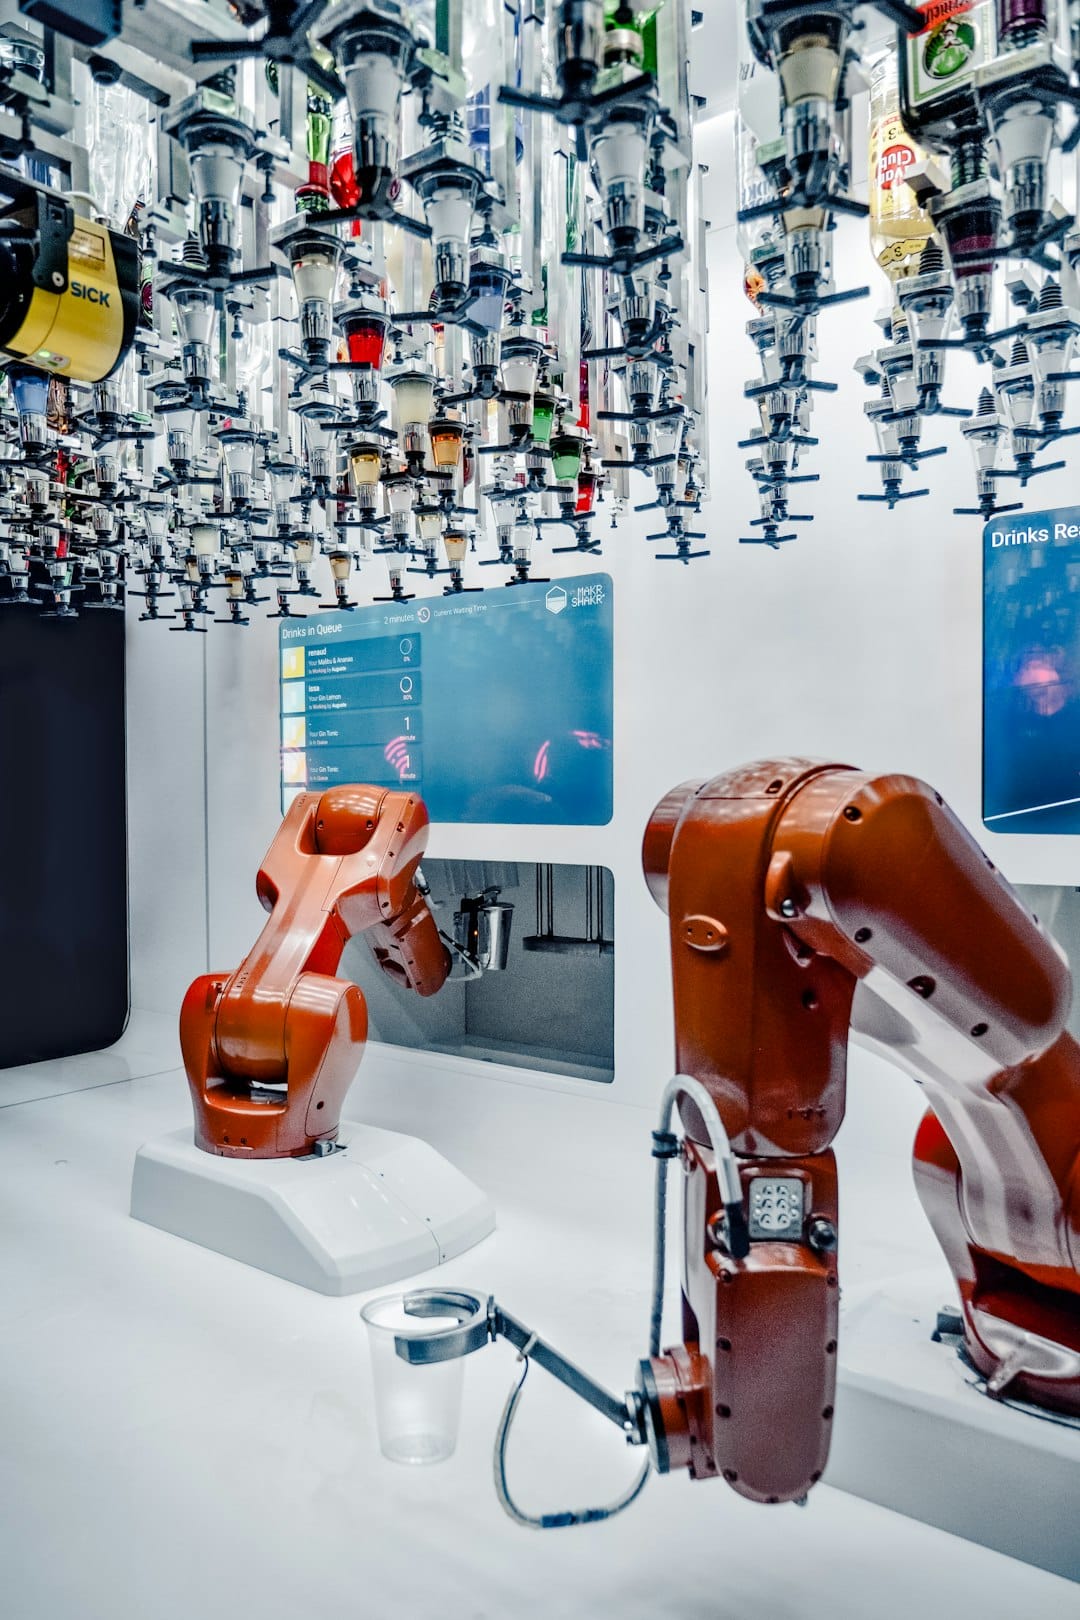
Die robotische Manipulation hat lange mit einem spezifischen Problem gekämpft. Traditionelle Systeme können zwar mühelos mehrere Haltegriffe für ein Objekt allein anhand der Geometrie identifizieren. Sie wählen jedoch oft nicht die Pose, die nachgelagerte Aktionen erfolgreich macht. Stellen Sie sich einen Roboter vor, der einen Wasserkessel perfekt hält, aber nicht schütten kann, weil er die funktionale Ausrichtung des Griffs verpasst hat. Ein neuer Zwei-Phasen-Rahmenwerk löst dieses Problem, indem es die Greifgenerierung von der semantischen reasoning entkoppelt. Dieser Ansatz verbessert die Genauigkeit bei der aufgabenspezifischen Auswahl erheblich.
Die Architektur arbeitet in zwei klar getrennten Phasen, um dieses Problem zu lösen. In Phase eins identifiziert ein Vision-Language-Modell (VLM) aufgabenrelevante Bereiche innerhalb einer RGB-D-Beobachtung. Dies steuert die Segmentierung und die Generierung plausibler 6-DoF-Greifkandidaten über GraspNet. Das Ergebnis ist eine Reihe von Vorschlägen, die sowohl geometrisch fundiert als auch an bestimmte Funktionsbereiche gebunden sind. In Phase zwei setzt ein strukturiertes VLM-Kritiksystem diese fundierten Kandidaten dann in Relation zueinander. Es bewertet sie basierend auf ihrer Kompatibilität mit der beabsichtigten Aufgabe, statt sich ausschließlich auf geometrische Scores zu verlassen. Dieser begrenzte Ansatz verhindert, dass das Modell unbeschränkte Posen generiert. Stattdessen wählt es aus einer validierten Menge von Kandidaten-IDs.
Umfangreiche Bewertungen über 60 physische Gesamtsystemversuche zeigten eine gesamte Aufgabenerfolgsrate von 63,3 Prozent. Die Tests deckten Aufgaben wie zufälliges Pick-and-Place, Hammer-Schlagen und Schütten ab. Kontrollierte Wiederholungsversuche ergaben erhebliche Leistungsunterschiede in Abhängigkeit von der gewählten VLM-Auswahl. Gemini 3 Flash Preview schnitt bei der Lokalisierung in Phase eins am besten ab. Es erreichte eine Genauigkeit von 95,0 Prozent bei der niedrigsten Latenz. Für das Ranking in Phase zwei zeigte GPT-5.6 Sol überlegene Zuverlässigkeit. Es sicherte sich eine Top-1-Erfolgsrate von 92,9 Prozent und zeigte die stärkste Konsistenz bei wiederholten Inferenzen.
Diese Studie verdeutlicht, dass die physische Aufgabenerledigung und das modell-spezifische Verhalten verschiedene Aspekte der Systemrobustheit abbilden. Eine Sensitivitätsanalyse zeigte, dass Änderungen in den Beweisen für vorgeschaltete Kandidaten die endgültigen Greifauswahlen verändern konnten. Dies unterstreicht die Notwendigkeit, beide Phasen gemeinsam zu bewerten. Durch die Trennung der semantischen Isolierung von der Kandidatenprüfung bietet dieser Rahmenwerk eine klarere Grundlage zur Bewertung von VLM-basierten Robotersystemen. Er geht über einfache Erfolgsmetriken hinaus, um zu verstehen, wo und warum Entscheidungen gelingen oder fehlschlagen. Diese Methodik bietet einen skalierbaren Weg zur Integration von hochrangiger reasoning in die niedrige robotische Steuerung. Sie stellt sicher, dass Roboter Objekte nicht nur greifen, sondern dies so tun, dass sie komplexe menschliche Anweisungen erfüllen.
Related in Gadgets

Gadgets
Warum Ihr Browser Nein sagt: Die verborgene Logik hinter Zugriffsverweigerungen
Die digitale Welt dreht sich rasant. Doch eine Erfahrung bleibt für Nutzer weltweit gleichermaßen frustrierend. Der plötzliche Stopp, wenn eine Website nicht lädt. Sie sehen die klare Meldung „Zugriff verweigert“ oder den HTTP-Code 403 Forbidden. Das ist kein zufälliger Fehler. E
Read More...
Gadgets
Warum Ihr Browser Nein sagt: Die verborgene Logik hinter Zugriffsverweigerungen
Haben Sie schon einmal auf einen leeren Bildschirm gestarrt, der sich einfach nicht öffnen ließ? Diese frustrierende Fehlermeldung "Zugriff verweigert" ist mehr als nur ein digitales Hindernis. Sie zeigt an, dass die Sicherheitssysteme des Internets genau so funktionieren, wie si
Read More...
Gadgets
COMBI-CBRN: Wie modulare Sensoren die Sicherheit von Feuerwehrleuten bei CBRN-Einsätzen neu definieren
Einsatzkräfte stehen bei chemischen, biologischen, radiologischen und nuklearen Zwischenfällen vor einer komplexen Herausforderung. Die Sicherheit der Retter hängt oft von der Genauigkeit der ersten Aufklärung ab. Herkömmliche Methoden nutzen meist separate Detektoren. Das führt
Read More...
Gadgets
Wie strukturaware Ausrichtung die KI-Genauigkeit beim Partial-Label-Learning steigert
Die künstliche Intelligenz steht vor einem hartnäckigen Problem. Perfekt annotierte Daten sind selten und teuer in der Beschaffung. Forscher haben daher das Partial-Label-Learning als Lösung entwickelt. Diese Methode ermöglicht es Modellen, aus mehrdeutiger Supervision zu lernen.
Read More...
Gadgets
MASC-Methode steigert die Genauigkeit der Unkrauterkennung ohne neue Hardware
Die Agrartechnologie durchläuft einen tiefgreifenden Wandel. Künstliche Intelligenz-Modelle werden zunehmend unempfindlicher gegenüber Umweltveränderungen. Eine neue Studie stellt das MASC-Framework vor. Der Name steht für Metadata-Guided Appearance-Shift Consistency. Dieser Trai
Read More...
Gadgets
KI erkennt Mängel an Strommasten: Präzisionsgewinn von 59 Prozent für die Netzsicherheit
Moderne Energieversorgungsnetze sind auf die Zuverlässigkeit ihrer Hochspannungsinfrastruktur angewiesen. Manuelle Inspektionen der massiven Stahlkonstruktionen sind arbeitsintensiv und fehleranfällig. Ein Durchbruch in der Computervision-Technologie bietet nun eine transformativ
Read More...
Gadgets
Wie fehlerbewusste HIL-Verifikation die AUTOSAR-Timing-Konformität in modernen ECUs sichert
Die Komplexität der Automobilelektronik steigt stetig. Daher ist die Sicherheitsintegrität von elektronischen Steuergeräten (ECUs) nach Normen wie ISO 26262 zu einer obersten Priorität geworden. Die funktionale Korrektheit wird zwar routinemäßig geprüft. Doch die zeitliche Korrek
Read More...
Gadgets
Grenzen von Class-D-Verstärkern: Warum die Schaltfrequenz die Audioqualität bestimmt
Class-D-Verstärker sind seit langem für ihre beeindruckende Energieeffizienz bekannt. Eine kristallklare Audioqualität erfordert jedoch das Navigieren durch ein komplexes Netz technischer Einschränkungen. Eine aktuelle Studie in der Zeitschrift Electronics (MDPI) bietet einen neu
Read More...
Gadgets
Warum Ihre Gewächshaus-Sensoren ausfallen: Das MQTT-Timing-Problem und wie Sie es lösen
Schweiz, Quelle: Smarte Gewächshäuser versprechen präzise Landwirtschaft durch kontinuierliche Datenströme. Viele Landwirte stehen jedoch vor einer frustrierenden Realität. Drahtlose Sensornetze scheitern oft an der eigenen Komplexität. Eine aktuelle Studie im Fachblatt Electroni
Read More...
Gadgets
Bitgenaue FPGA-Steuerung: Zuverlässiger PV-STATCOM-Betrieb in schwachen Netzen
Die Integration erneuerbarer Energien schreitet voran. Die Stabilität von Stromnetzen bei Spannungseinbrüchen und unter schwachen Netzbedingungen ist zu einer kritischen ingenieurtechnischen Herausforderung geworden. Eine aktuelle Studie im Fachjournal Electronics (MDPI) behandel
Read More...