
Por qué fallan tus robots al verter líquidos: La solución de IA en dos etapas para el agarre específico
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
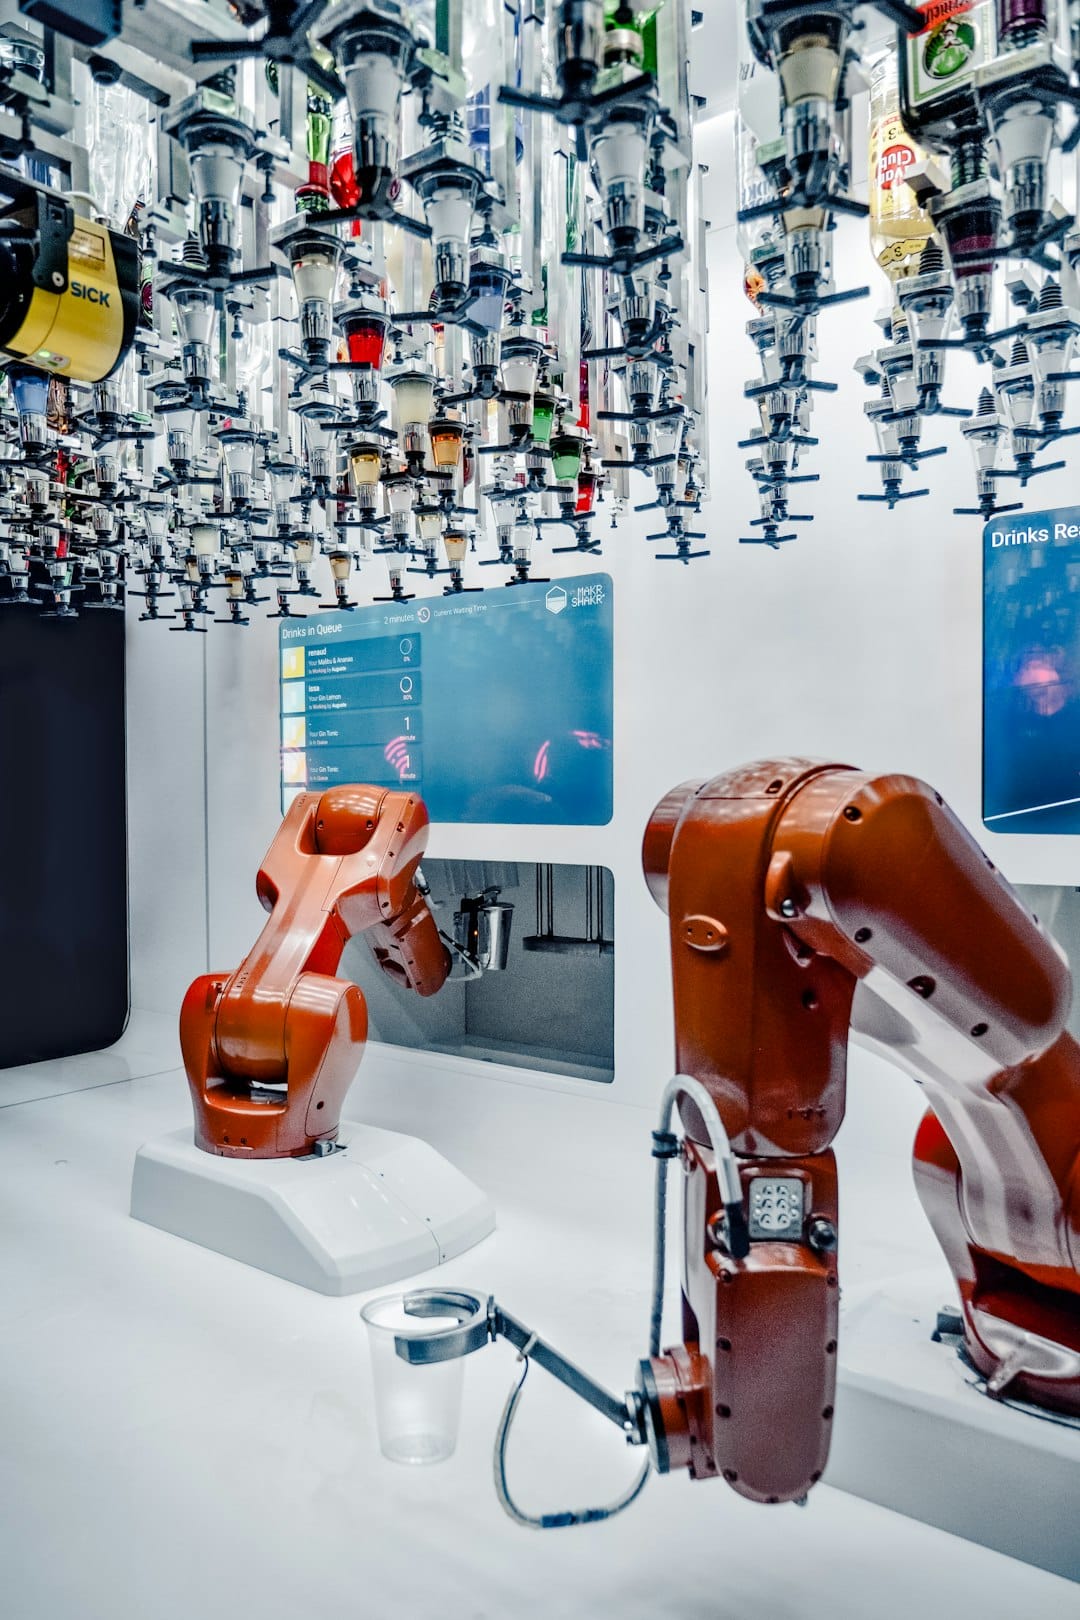
La manipulación robótica lleva tiempo luchando contra una desconexión específica. Los sistemas tradicionales pueden identificar fácilmente múltiples formas de sostener un objeto basándose únicamente en la geometría. Sin embargo, a menudo fracasan al seleccionar la postura que permite realizar acciones posteriores con éxito. Imagina un robot sosteniendo perfectamente una tetera pero incapaz de verter el líquido porque ignoró la orientación funcional del asa. Un nuevo marco de trabajo en dos fases aborda este problema separando la generación del agarre del razonamiento semántico. Este enfoque mejora significativamente la precisión en la selección condicionada por la tarea.
La arquitectura opera en dos fases distintas para resolver este problema. En la primera fase, un Modelo de Lenguaje y Visión identifica las regiones relevantes para la tarea dentro de una observación RGB-D. Esto guía la segmentación y la generación de candidatos de agarre plausibles en 6 grados de libertad mediante GraspNet. El resultado es un conjunto de propuestas que son geométricamente sólidas y están vinculadas a áreas funcionales específicas. En la segunda fase, se utiliza un crítico estructurado basado en VLM para clasificar estos candidatos fundamentados. Evalúa su compatibilidad con la tarea prevista en lugar de depender únicamente de puntuaciones geométricas. Este enfoque acotado evita que el modelo genere posturas sin restricciones. En su lugar, selecciona de un conjunto validado de identificadores de candidatos.
Una evaluación exhaustiva realizada en 60 pruebas físicas completas del sistema mostró una tasa de éxito general del 63,3 %. Las pruebas cubrieron tareas como recoger y colocar objetos al azar, golpear con un martillo y verter líquidos. Experimentos controlados de repetición revelaron variaciones significativas en el rendimiento dependiendo de la elección del VLM. Gemini 3 Flash Preview surgió como el mejor performer para la localización en la Fase 1. Logró una precisión del 95,0 % con la menor latencia. Para la clasificación en la Fase 2, GPT-5.6 Sol demostró una fiabilidad superior. Aseguró una tasa Top-1 de validez de tarea del 92,9 % y mostró la mayor consistencia en inferencias repetidas.
Este estudio destaca que la finalización de tareas físicas y el comportamiento específico del modelo capturan diferentes aspectos de la robustez del sistema. El análisis de sensibilidad mostró que los cambios en la evidencia de candidatos previos podían alterar las selecciones finales de agarre. Esto enfatiza la necesidad de evaluar ambas fases de manera conjunta. Al separar el aislamiento semántico de la auditoría de candidatos, este marco proporciona una base más clara para evaluar sistemas robóticos basados en VLM. Va más allá de las métricas de éxito simples para entender dónde y por qué las decisiones tienen éxito o fracasan. Esta metodología ofrece un camino escalable para integrar el razonamiento de alto nivel en el control robótico de bajo nivel. Garantiza que los robots no solo agarren objetos, sino que lo hagan de una manera que cumpla instrucciones humanas complejas.
Related in Gadgets

Gadgets
Por qué tu navegador dice que no: La lógica oculta detrás de los errores de acceso denegado
El mundo digital avanza a gran velocidad. Sin embargo, hay una experiencia que sigue frustrando a usuarios de todo el planeta. Ese bloqueo repentino cuando un sitio web se niega a cargar. Aparece el mensaje claro 'Acceso denegado' o el código HTTP 403 Prohibido. Esto no es un err
Read More...
Gadgets
Por qué tu navegador dice que no: La lógica oculta detrás de los errores de acceso denegado
¿Alguna vez has mirado una pantalla en blanco que se niega a dejarte entrar? Ese mensaje frustrante de 'Acceso denegado' es más que un simple obstáculo digital. Es una señal de que los sistemas de seguridad de internet están funcionando exactamente como deberían. Cuando ves un có
Read More...
Gadgets
COMBI-CBRN: Cómo los sensores modulares están redefiniendo la seguridad de los bomberos en emergencias CBRN
Los equipos de respuesta a emergencias enfrentan un rompecabezas complejo al lidiar con incidentes químicos, biológicos, radiológicos y nucleares. La seguridad de los primeros intervinientes depende a menudo de la precisión del reconocimiento inicial. Los métodos tradicionales su
Read More...
Gadgets
Cómo la alineación consciente de la estructura mejora la precisión de la IA en el aprendizaje con etiquetas parciales
La inteligencia artificial se enfrenta a un obstáculo persistente. Los datos perfectamente etiquetados son escasos y costosos de obtener. Los investigadores han recurrido al aprendizaje con etiquetas parciales como solución. Este método permite que los modelos aprendan de una sup
Read More...
Gadgets
Aumenta la precisión de la IA para detectar malezas sin nuevo hardware: el método MASC
La tecnología agrícola está viviendo un cambio importante. Los modelos de inteligencia artificial se vuelven más resistentes a las variaciones ambientales. Un nuevo estudio presenta MASC. Este acrónimo corresponde a Metadata-Guided Appearance-Shift Consistency. Se trata de un mar
Read More...
Gadgets
La IA detecta fallos en torres de transmisión: un aumento del 59% en la precisión para la seguridad de la red
Las redes energéticas modernas dependen de la fiabilidad de su infraestructura de transmisión eléctrica. Las inspecciones manuales de estas enormes estructuras de acero siguen siendo laboriosas y propensas a errores humanos. Una nueva innovación en visión por computadora ofrece u
Read More...
Gadgets
Cómo la verificación HIL consciente de fallos garantiza el cumplimiento del cronograma AUTOSAR en ECUs modernas
La electrónica automotriz se vuelve cada vez más compleja. Garantizar la integridad de seguridad de las Unidades de Control Electrónico (ECU) es ahora una prioridad bajo normas como ISO 26262. La corrección funcional suele validarse con facilidad. Sin embargo, la corrección tempo
Read More...
Gadgets
Por qué te bloquean: la mecánica oculta del control de acceso web
¿Alguna vez has mirado una pantalla y visto esas tres palabras inquietantes: Acceso denegado? No se trata de un simple fallo técnico. Es el resultado de protocolos de seguridad sofisticados que trabajan incansablemente para proteger los recursos del servidor y los datos sensibles
Read More...
Gadgets
Límites de los amplificadores Clase D: Por qué la frecuencia de conmutación define tu fidelidad de audio
Los amplificadores Clase D llevan tiempo siendo elogiados por su impresionante eficiencia energética. Sin embargo, lograr una calidad de audio impecable exige navegar por una compleja red de restricciones técnicas. Un estudio reciente publicado en Electronics (MDPI) presenta un n
Read More...
Gadgets
Por qué fallan los sensores de tu invernadero: La trampa del temporizador MQTT y cómo solucionarlo
Suiza, Fuente: Los invernaderos inteligentes prometen agricultura de precisión mediante flujos de datos continuos. Sin embargo, muchos agricultores enfrentan una realidad frustrante donde las redes de sensores inalámbricos colapsan bajo su propia complejidad. Un estudio reciente
Read More...