
Как рассуждения больших языковых моделей повышают безопасность автономных автомобилей на 63 процента: новая система обучения с подкреплением
We compile, generate and translate using Artificial Intelligence from the below given source. Macro Micro News is responsible for its editorial publication.
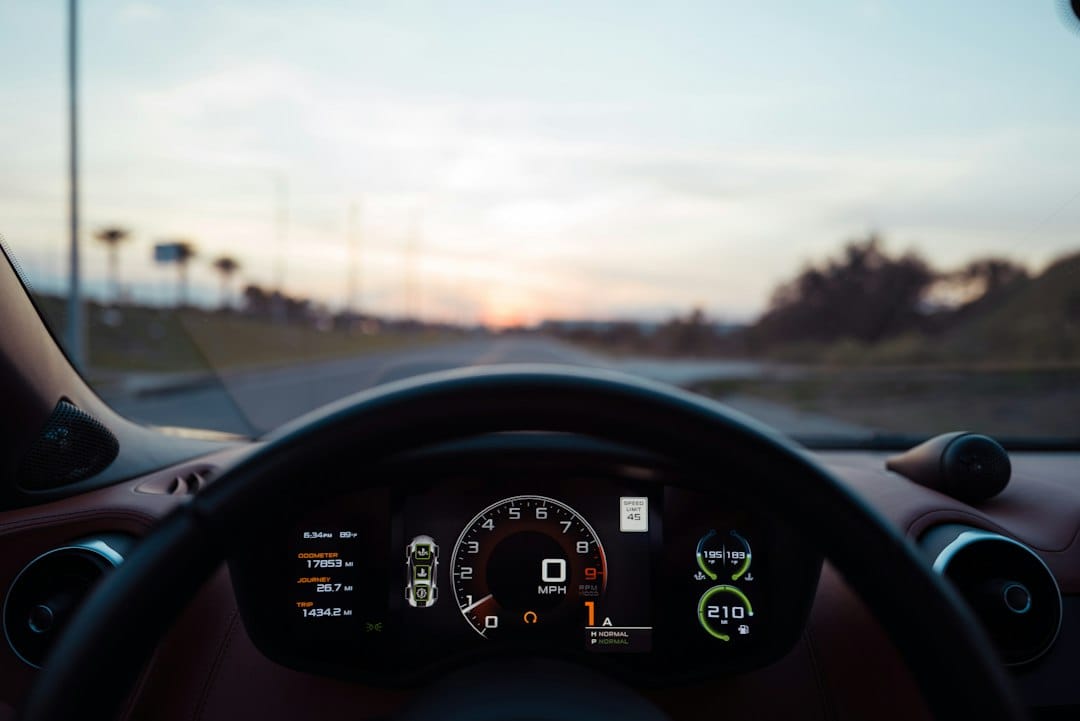
Развитие полностью автономных транспортных средств идет быстрыми темпами. Впереди нас ждет будущее, где дороги станут безопаснее, а транспортный поток будет работать эффективнее. Однако путь к этой цели не лишен препятствий. Традиционные модели обучения с подкреплением долгое время оставались основой для принятия решений в беспилотных автомобилях. Эти системы учатся взаимодействовать с окружающей средой и накапливают огромные объемы данных для совершенствования своих стратегий вождения. Они отлично справляются со своими задачами в контролируемых условиях. Но им часто трудно интерпретировать более широкий контекст. Сюда входят правила дорожного движения, этические нормы и человеческая интуиция. Этот пробел может приводить к непредсказуемым действиям, которые снижают уровень безопасности.
Исследователи предложили интересное решение, способное преодолеть этот разрыв. Они объединили рассуждения больших языковых моделей (LLM) с обучением с подкреплением. Получившаяся гибридная система использует сильные стороны обоих подходов. В основе лежит модель, сочетающая зрение и язык. Она сканирует дорогу перед автомобилем и переводит визуальные данные в подробные текстовые описания. Система фиксирует все детали от планировки перекрестков до движений пешеходов и скорости других машин. Затем этот богатый контекст передается в большую языковую модель вместе со структурированными запросами. В них содержатся правила дорожного движения, принципы оборонительного вождения и информация о прошлом опыте вождения.
Большая языковая модель выполняет рассуждения высокого уровня. Она генерирует эталонные действия, соответствующие человеческим нормам и законодательным требованиям. Как гарантировать безопасность этих предложений? Многоуровневая система защиты выступает в роли страховки. Она проверяет решения через фоновое сопоставление, проверку логики и строгие ограничения безопасности. Этот процесс отсеивает галлюцинации или команды, которые физически невозможно выполнить автомобилю. Тем временем компонент обучения с подкреплением продолжает оптимизировать свою сеть политик. Он объединяет данные об окружающей среде, состояние собственного транспортного средства и предыдущие траектории движения.
Динамический механизм переключения балансирует влияние большой языковой модели и агента обучения с подкреплением в процессе тренировки. По мере того как агент становится более профессиональным, система постепенно снижает зависимость от языковой модели. Этот переход позволяет автомобилю сохранять надежные способности к принятию решений. При этом он использует первоначальные подсказки, предоставленные языковой моделью. В результате адаптация к сложным дорожным условиям происходит более плавно.
Тестирование этой системы на платформе симуляции CARLA показало впечатляющие результаты. При сравнении с современными алгоритмами PPO и SAC новый подход значительно снизил количество столкновений почти на 63,1 процента. Также улучшились показатели успешного выполнения задач в плотном и сложном транспортном потоке. Объединение здравого смысла больших языковых моделей с адаптивными возможностями обучения с подкреплением открывает перспективный путь. Эта технология ведет к созданию надежных систем автономного вождения, готовых к реальным вызовам.
Related in Gadgets

Gadgets
Почему браузер блокирует доступ: скрытая логика ошибок Access Denied
Цифровой мир развивается стремительно. Но одна ситуация вызывает раздражение у пользователей по всему миру. Это внезапная остановка, когда сайт отказывается загружаться. Вы видите суровое сообщение "Доступ запрещен" или код ошибки HTTP 403 Forbidden. Эта ошибка не случайна. Она я
Read More...
Gadgets
Почему браузер говорит «нет»: скрытая логика ошибок доступа
Вы когда-нибудь смотрели на пустой экран, который просто не пускает вас внутрь? Раздражающее сообщение об отказе в доступе — это не просто цифровое препятствие. Это признак того, что системы безопасности интернета работают именно так, как задумано. Когда вы видите код HTTP 403 Fo
Read More...
Gadgets
COMBI-CBRN: как модульные датчики меняют правила безопасности пожарных при ЧС с применением ОМП
Командам экстренного реагирования приходится решать сложную задачу при работе с инцидентами, связанными с химическими, биологическими, радиологическими и ядерными угрозами. Безопасность спасателей часто зависит от точности первоначальной разведки. Традиционные методы опираются на
Read More...
Gadgets
Как выравнивание с учетом структуры повышает точность ИИ в обучении с частичными метками
Искусственный интеллект сталкивается с устойчивой проблемой. Идеально размеченные данные редки и дороги в получении. Исследователи обратились к обучению с частичными метками как к решению. Этот метод позволяет моделям учиться на основе неопределенных инструкций. Каждый объект соп
Read More...
Gadgets
Повышение точности ИИ для обнаружения сорняков без нового оборудования: метод MASC
Сельскохозяйственные технологии переживают масштабный сдвиг. Модели искусственного интеллекта становятся устойчивее к изменениям окружающей среды. Новое исследование представляет метод MASC (Metadata-Guided Appearance-Shift Consistency). Это обучающая рамка, которая улучшает обна
Read More...
Gadgets
ИИ выявляет дефекты опор ЛЭП: точность повышена на 59% для безопасности сетей
Надежность современных энергосистем напрямую зависит от состояния линий электропередачи. Ручной осмотр высоких стальных конструкций требует много сил и часто сопровождается человеческими ошибками. Новые технологии компьютерного зрения предлагают эффективное решение для поиска сла
Read More...
Gadgets
Как верификация HIL с учетом отказов обеспечивает соответствие таймингам AUTOSAR в современных ЭБУ
С ростом сложности автомобильной электроники обеспечение функциональной безопасности электронных блоков управления (ЭБУ) стало приоритетной задачей. Стандарты, такие как ISO 26262, диктуют строгие требования к целостности безопасности. Функциональная корректность проверяется регу
Read More...
Gadgets
Почему вас заблокировали: скрытые механизмы контроля доступа к веб-ресурсам
Вы когда-нибудь смотрели на экран и видели зловещие слова "Доступ запрещен"? Это не просто технический сбой. Так работают сложные протоколы безопасности, защищающие ресурсы серверов и конфиденциальные данные. Такое поведение является фундаментальной частью того, как современные с
Read More...
Gadgets
Пределы усилителей класса D: почему частота коммутации определяет качество звука
Усилители класса D давно известны своей высокой энергоэффективностью. Однако для достижения безупречного качества звука приходится преодолевать сложные технические ограничения. Недавнее исследование, опубликованное в журнале Electronics (MDPI), предлагает новую методологию выбора
Read More...
Gadgets
Почему датчики в теплице дают сбои: ловушка таймингов MQTT и способы её решения
Умные теплицы обещают точное земледелие благодаря непрерывному потоку данных. На практике многие фермеры сталкиваются с проблемами. Беспроводные сети датчиков часто ломаются под тяжестью собственной сложности. Недавнее исследование, опубликованное в журнале Electronics (MDPI), пр
Read More...